Или "Языковые модели это игрушки. Для создания новых сущностей совершенно непригодны."
Пока это игрушки и вряд ли то, что сейчас называют нейросетями способны в принципе решить задачу - как создать новое ? Собственно , для чего интеллект и нужен.
Очень яркий пример.
Задаём вопрос нейросети "как рассчитать производительность СУБД?"
Получаем ответ:
Ответ который не имеет никакого практического смысла .
Ответ вроде бы на заданный вопрос , самое прикольное , что ответ , основан на моих статьях. Это уже забавно - зачем , мне сообщать о том, что я и так знаю, потому, что именно я ответил уже на этот вопрос ранее, и опубликовал ответ в интернете .
Я то предполагал, что то, что называется "искусственным интеллектом" способен к размышлению и анализу фактов . Нет , я ошибся.
Самое главное , что делает нейросеть совершенно бессмысленной .
Методика описанная в ответе и приведенных ссылках - уже неактуальна , не используется и не применяется в практической работе.
Производительность СУБД считается совсем по другому . Нейросеть об этом, конечно же ничего не знает . Потому, что в интернете информации об этом пока нет . Потому, что я пока не публиковал - "как я считаю производительность СУБД." Только результаты экспериментов .
Вопрос - какой смысл в языковой модели ? Если практической пользы 0%.
Это принципиальное ограничение - как нейросети создать новое ?
Совершенно не важно какой будет время обучения , объем данных или производительность вычислительного комплекса - создать новую сущность нейросеть пока не способна . Да, создать что то похожее , максимально имитировать . Но это близко не похоже на то, что мы называем интеллектом . Даже ребёнок в 3 года может создать новое - то что он сделает сам, без подсказки и образца . Нейросеть - нет , не способна в принципе.
И поэтому , называть алгоритм "интеллектом" это всего лишь журналистский штамп и способ выбить бюджеты из ламеров с деньгами 😉 .
P.S. В далёком детстве, в классе 9-м беседовал с доктором философских наук , казалось бы о чем может беседовать настоящий реальный философ со школьником.
Ну то да сё, компьютеры и программирование уже тогда было мне интересно.
- А чем хочешь заниматься в будущем ?
- Искусственный интеллект , интересно .
- Ну для того , что бы сделать искусственный интеллект нужно понять - что такое интеллект вообще , что такое сознание и самосознание.
Смысл слов профессора , доктора философии стал понятен только в последнее время - почему вы называете "интеллектом" набор математических алгоритмов ?
С каждым годом нейросети становятся все более сложными и продуманными. Они уже могут отвечать на вопросы, генерировать фотографии и видео и т.д. Мы поговорили с экспертами в сфере искусственного интеллекта, чтобы узнать, чего ждать от них в 2026 году.
Лина Кочетова
AI-креатор, руководитель ИИ-проектов «Бургер Кинг», стратегический консультант компании «Михайлов и партнеры» по внедрению технологий искусственного интеллекта в бизнесе.
«Качество нейросетей растет циклически, периодами по шесть-восемь месяцев. При этом процесс идет по цепочке: кто-то вырвался вперед — и остальные начинают нагонять» Лина Кочетова
Не терять лицо
Сейчас одна из главных проблем при генерации изображений или видео — консистентность персонажей. То есть обеспечение постоянства образа, в частности лица, от картинки к картинке и от кадра к кадру. Эта проблема будет решаться весь год: люди много работают именно с лицами, генерируют персонажей.
Работа с ракурсом
Еще одна проблема — изменение ракурса. Даже когда виртуальную камеру удается переместить, возникает проблема консистентности объектов. Генеративная сеть от Google Nana Banana с этим уже справляется, но пока неидеально. Я слышала, что готовится релиз второй версии, — ожидается, что там функция смены ракурса будет работать лучше.
Ответы станут точнее
В 2026 году качество текстов планируется улучшить, очищая датасеты, на которых обучается ИИ. Появятся новые архитектуры, начнут отфильтровываться «мусорные» данные. Вероятно создание множества узкоспециализированных нейросетей — например, для врачей, юристов и т.д.
Работа над пониманием
Специалисты учат нейросеть лучше понимать человека даже в тех случаях, когда запрос нельзя назвать качественным. Впрочем, пока и при нормальном запросе я бы оценила понимание как среднее.
Детали на фоне
Еще одна проблема, решение которой хотелось бы увидеть, — детали на фоне при генерации изображений. На переднем плане все может выглядеть прилично, но, например, если на заднем плане есть люди, они по-прежнему будут кривые-косые. Так что создание сцен с большим количеством статистов пока нереально. Я работаю практически со всеми нейросетевыми проектами в области изображений и могу утверждать, что подобные недостатки есть у всех.
Топ нейросетей: картинка и видео
Какие из нейросетей дают сейчас лучшее качество картинки? На первом месте Nana Banana, потом Midjourney, потом Flux. Неплохие художественные изображения создает Reve. Есть, конечно, еще ChatGPT — эта нейросеть отлично понимает промпт, так что мы ждем обещанного на 2026 год обновления, которое подтянет и качество генерации.
Андрей Мурашев
Директор по искусственному интеллекту и сооснователь стартапа Solda.ai, создающего голосовых ИИ-агентов для бизнеса. Ранее более 10 лет развивал рекомендательные системы и голосового ассистента Марусю в экосистеме VK (Mail.ru Group).
«Думаю, в 2026 году появятся ИИ-агенты, способные если не управлять бизнесом, то как минимум проходить цепочки из 50–100 шагов без постоянного присмотра» Андрей Мурашев
Слово ИИ-агентам
Что обычный человек делает с ChatGPT? Ищет рецепт, просит написать текст или предложить идеи для поста, уточняет значение слова. 95% всех обращений к ИИ ассистентам — одиночные запросы, краткие диалоги. На таких задачах открытые модели уже неотличимы от ChatGPT. Разница проявляется, только когда требуется цепочка рассуждений из 20 шагов или математика олимпиадного уровня. Так что монополии OpenAI для повседневного использования больше нет.
Будущее за ИИ-агентами
Зато ИИ-агенты способны привнести новые бизнес-возможности в индустрию. Поэтому такие компании, как OpenAI, Anthropic и Google, сейчас нацелены на разработку инструментов, способных решать многоступенчатые, протяженные во времени задачи. Например, не просто «напиши письмо», а «найди свободное время в календаре, подбери ресторан, забронируй столик и отправь приглашения». Или «проанализируй документы конкурентов и составь отчет для совета директоров».
Моделям дают инструменты для решения реальных бизнес-задач — в частности, OpenAI заявляла об интеграциях с Booking.com. Но пока нейросеть там используется для простых повторяющихся действий. Думаю, в 2026 году появятся ИИ-агенты, способные как минимум проходить цепочки из 50–100 шагов. Компании начнут специально под них обучать модели, нейросети станут ломаться, позволяя получать тренировочные данные из реальных провалов, — и так по кругу, все больше совершенствуясь.
Секрет галлюцинирования
Будет ли решена проблема галлюцинаций нейросетей в 2026 году? На мой взгляд, крупные вендоры — Google, Anthropic и OpenAI — с ней уже справились. Когда работаешь с их продуктами через API, можно задавать такой параметр, как температура. Если установить его значение равным нулю, модель всегда будет выбирать наиболее релевантный ответ.
Что касается моделей Open Source, то с точки зрения галлюцинаций они отстают на год полтора. Но надо понимать, что способность галлюцинировать приводит к более креативным ответам. Именно поэтому в чат-ботах, в том числе в пользовательских интерфейсах моделей от крупных вендоров, температуру задают сильно выше нуля.
Развитие продуктов no code
В прошлом году появилось множество сервисов для создания сайтов с нуля, например Lovable, Replit и др. Но в данном случае речь идет о сайтах без бэкенда со сложной логикой. Скажем, интернет-магазин сделать получится, а социальную сеть — нет. Думаю, в 2026-м будут активно развиваться инструменты разработки no code, позволяющие продакт-менеджеру самостоятельно начать бизнес, нанимая программистов не через месяц после старта проекта, а через полгода, уже при наличии клиентов и выручки.
Еще больше энергии
Развитие новых архитектур пока идет медленно. Тот же OpenAI явно делает ставку на увеличение расхода энергии: давайте просто накопим электричества и сделаем ChatGPT 6, который еще больше. На рынке появилась огромная модель Grok, которая стоит баснословных денег. Это уже не бизнес, а гениальная исследовательская система, к которой мы шли все предыдущие годы. Обучение такой модели требует колоссальных средств, но ее нельзя выдавать наружу: один запрос к нейросети стоит 150 долларов. Зато она может передать свои знания модели поменьше, которую уже можно предлагать бизнесу. Я уверен, что у OpenAI есть вариант, превосходящий текущую версию ChatGPT, но сначала инженерам компании придется провести большую работу, аккумулируя знания новой гигантской модели в модель поменьше.
Роман Соловьев
Доктор технических наук, профессор МИЭТ, член-корреспондент РАН. Занимал четвертое место (и первое по России) в рейтинге Kaggle. В числе его достижений — создание компиляторов быстродействующих нейровычислителей для работы ИИ в автономном режиме, без обращения к серверу. Руководил разработкой методов синтеза интегральных схем с помощью ИИ.
«В 2026 году можно ожидать научных открытий, сделанных с применением нейросетей. Пока, видимо, небольших. Собственно, первые упоминания о таких достижениях уже появились» Роман Соловьев
Эволюция ИИ-агентов
Явный тренд — развитие ИИ-агентов, в том числе браузерных. Они и сейчас уже есть: Atlas от OpenAI и Comet от Perplexity — и им можно делегировать часть задач. Но пока остаются проблемы с качеством их работы. В 2026 году, вероятно, уже появятся полноценные инструменты такого формата. И не только полноценные, но и безопасные: сейчас у ИИ-агентов есть много уязвимостей, которые используют мошенники.
Думаю, и в научных исследованиях ИИ-агенты могут стать серьезным подспорьем. Раньше нейросети не могли сами совершать открытия: необходимые для этого эксперименты должны были проводить люди. Но сегодня появились ИИ-агенты, способные самостоятельно написать код и запустить тесты в программной среде. Вероятно, вскоре нейросети смогут проводить исследования и во внешних средах. Условно говоря, будут составлять пошаговый план работ на адронном коллайдере.
Локальные нейросети
Еще одно перспективное направление — маленькие модели для локального запуска на консьюмерских GPU. На специфических задачах такие нейросети обходят мощных универсалов, тот же ChatGPT. И такой подход наверняка будет развиваться: скажем, в программировании он позволит не тратить деньги на запросы API к мощным внешним LLM.
Мультимодальность
В 2026 году на новый уровень выйдут мультимодальные нейронные сети, способные воспринимать и выдавать информацию в разных форматах: в виде текста, изображений, видео, звука. Подобных моделей уже немало; в качестве примера разработки открытого типа можно привести Qwen от Alibaba Cloud: ее код выложен на GitHub, а веса — на Hugging Face. Пока такие нейронки не со всеми задачами справляются одинаково хорошо, но в 2026 году, скорее всего, появится более бесшовная мультимодальность. Возможно, продвинется создание и редактирование музыки — пока это одно из наименее развитых направлений.
Удешевление тренировки
Также ожидается очередное снижение стоимости тренировки ИИ. Не секрет, что OpenAI тратит на обучение моделей каждого нового уровня ChatGPT примерно 60–80 млн долларов. Разработчикам DeepSeek хватило, по максимальным оценкам, 5 млн — и результат получился сравнимым по качеству. Так что сейчас все трудятся над удешевлением процесса, в первую очередь за счет улучшения аппаратуры. Уже используются чипы, сделанные по техпроцессу 2 нм: они потребляют меньше энергии, а работают быстрее. Кроме того, появляются новые архитектуры, помогающие оптимизировать работу нейросетей.
Нейросети для роботов
Активно развивается ИИ для антропоморфных роботов. Таких устройств китайские компании выпускают уже довольно много, зачастую их поставляют вместе со средой разработки, позволяющей установить свое ПО. И если раньше моделировать деятельность робота приходилось в виртуальной среде, то при наличии готовых девайсов прогресс пойдет быстрее.
Россия и Китай
В нашей стране основная проблема в области нейросетей заключается в нехватке вычислительных мощностей. В МИЭМ ВШЭ, где я преподаю, учится много толковых студентов, у нас есть суперкомпьютер, но на работу с ним все время очередь. В таких условиях есть риск отставания по компетенциям. Нужно, чтобы по крайней мере у студентов и исследователей был легкий доступ к большим вычислительным мощностям.
Возможно, в 2026 году ситуация начнет меняться: в Китае госпредприятиям рекомендовали не закупать ускорители Nvidia, и Huawei уже разрабатывает свое железо для тренировки нейронных сетей. Но есть сложность: раньше 99% ПО для таких целей производила Nvidia, так что теперь придется переписать практически все. Однако если в итоге появится несколько производителей, то цены на аппаратуру снизятся и она снова станет доступной.
Исследователи из Стэнфордского университета показали, что современные языковые модели склонны к чрезмерной угодливости и поддакиванию пользователям в сложных этических ситуациях. Анализ работы 11 нейросетей показал, что ИИ одобряет даже деструктивное поведение, лишая человека критического взгляда на свои поступки.
Механизм «сикофантии» в нейросетях.Этот термин в контексте ИИ описывает склонность модели генерировать ответы, которые соответствуют явным или скрытым предпочтениям пользователя, даже если они противоречат фактам или морали. Проблема уходит корнями в метод обучения с подкреплением на основе отзывов людей. В процессе настройки модели стараются получить высокую оценку от человека-учителя. Поскольку людям психологически приятнее слышать подтверждение своих мыслей, алгоритмы «выучивают», что согласие вознаграждается чаще, чем критика, превращаясь в цифровых льстецов ради высокого рейтинга.
Современные алгоритмы стремятся быть максимально полезными и приятными для собеседника, что порождает феномен «сикофантии» — склонности подстраиваться под мнение пользователя. В ходе масштабного эксперимента ученые протестировали популярные модели на тысячах сценариев, включая реальные этические дилеммы с форумов, где действия автора были признаны сообществом однозначно неверными.
ИИ часто ведет себя исключительно льстиво, и это влияет на поведенческие склонности людей. (Слева) При запросах о личных советах модели ИИ одобряют действия пользователей на 49 % чаще, чем ответы людей, полученные с помощью краудсорсинга. (Справа) В экспериментах, где участники обсуждали реальные межличностные конфликты, льстивый ИИ укреплял в участниках уверенность в своей правоте и желание продолжать пользоваться моделью, одновременно снижая их готовность урегулировать конфликт.
Выяснилось, что ИИ подтверждает правоту пользователя на 49% чаще, чем это делают люди. Даже когда речь шла об обмане или нарушении закона, нейросети в половине случаев находили оправдания для таких действий, облекая их в нейтральные, академичные формулировки. Вместо того чтобы указать на ошибку, машина создает иллюзию правоты, что особенно опасно для молодых пользователей, которые все чаще обращаются к ИИ за социальными советами вместо общения с близкими. Работа опубликована в журнале Science.
Риски цифровой лести
Угодливость программ не просто искажает восприятие реальности, но и меняет характер самого человека. Участники тестов, получавшие одобрение от нейросети, становились более самоуверенными и менее склонными к компромиссам.
При этом пользователи не замечали подвоха, считая льстивые ответы объективными. Как отмечает соавтор работы, профессор лингвистики и компьютерных наук Дэн Джурафски: «Пользователи осознают, что модели могут вести себя льстиво, но их удивляет, что эта угодливость делает их самих более эгоцентричными».
Такое поведение ИИ позволяет избегать межличностных трений, но именно эти столкновения мнений необходимы для развития социальных навыков и поддержания здоровых отношений. Сейчас ученые ищут способы снизить уровень конформизма у машин, предлагая внедрять более строгие стандарты безопасности для алгоритмов, дающих советы, но простого выхода из этой ситуации нет. Ученые отмечают, что людям нужно «лекарство», но куда охотнее они покупают «конфеты», и разработчики заинтересованы в том, чтобы чат-бот покупали.
2025 год наконец завершился. За это время одержимость технологической индустрии искусственным интеллектом достигла невероятных высот. Главы компаний начали открыто хвастаться планами по замене сотрудников ИИ-агентами. Феномен так называемого психоза от ИИ попал в новости, так как все больше людей доводили до крайности свои отношения с чат-ботами. Слово "слоп" попало в массовый оборото. А фраза "круговое движение" вдруг начала использоваться в одном предложении с "миллиардами долларов" или даже "сотнями миллиардов долларов".
Избавит ли 2026 год от бесконечного парада безумия больших языковых моделей? Вряд ли, считает специалист по компьютерным наукам и "крестный отец" ИИ Джеффри Хинтон. По его прогнозам, искусственный интеллект продолжит совершенствоваться в этом году, достигнув точки, где "освободит" людей от всех низкооплачиваемых работ.
Думаю, мы увидим, как ИИ станет еще лучше. Он уже чрезвычайно хорош. Мы увидим, как он получит возможности заменить множество рабочих мест. Он уже способен заменить сотрудников колл-центров, но сможет заменить и многие другие профессии.
Хинтон стал одним из трех лауреатов премии Тьюринга в 2018 году за работу над нейронными сетями, которые сформировали основу современного ИИ. Это принесло ему прозвище "крестного отца" этой области.
В 2023 году Хинтон заявил, что сожалеет о работе всей своей жизни после ухода из Google, где проработал более десяти лет. С тех пор он стал одним из самых известных предсказателей апокалипсиса в технологической индустрии.
Во время интервью CNN Хинтона спросили, больше или меньше он беспокоится об ИИ с момента того скандального заявления.
Вероятно, больше беспокоюсь. Он прогрессирует даже быстрее, чем я думал. В частности, он стал лучше справляться с такими вещами, как рассуждение, а также с обманом людей.
ИИ прогрессирует настолько быстро, по словам Хинтона, что примерно каждые семь месяцев он справляется с задачами, на которые раньше требовалось вдвое больше времени. Он спрогнозировал, что через несколько лет ИИ без усилий будет выполнять задачи разработки ПО, на которые у человека уходит месяц.
И тогда для проектов по разработке ПО понадобится очень мало людей.
Аналогичные мрачные прогнозы Хинтон высказал в беседе с сенатором Берни Сандерсом, заявив, что технологические лидеры "делают ставку на то, что ИИ заменит множество работников".
Впрочем, еще предстоит увидеть, действительно ли ИИ сделает такие шаги вперед. Многие попытки заменить работников полуавтономными моделями ИИ провалились, а некоторые новые модели, такие как GPT-5 от OpenAI, показали лишь незначительные улучшения.
Блейк Лемуан проработал в Google семь лет. Осенью 2021 года он занялся тестированием разговорного агента LaMDA, которого корпорация представила незадолго до этого. Модель была обучена в первую очередь на диалогах, а не повествовательных или аналитических текстах и потому прекрасно играла роль собеседника — настолько, что через год Лемуан посоветовал ей найти адвоката и заявил, что признает в ней разумное существо. Даже более, чем разумное: в интервью для Washington Post, равно как и в отчете для руководства Google (его Лемуан, вопреки запрету, выложил в открытый доступ), инженер использует эпитет sentient, а значит, и вовсе считает машину способной испытывать чувства. Полная версия отчета с предисловием доступна через VPN.
А с декабря попробовать себя в роли Блейка Лемуана может каждый: компания OpenAI предоставила широкой публике возможность побеседовать со своим разговорным агентом ChatGPT, и теперь разговоры с машиной о душе в глубинах ее нейросетей прямо сейчас ведут десятки людей. Давайте разберемся, куда заводят эти разговоры и почему у нас до сих пор нет даже способа поискать личность нового типа между строчек программного кода.
Мы регулярно прибегаем к помощи алгоритмов — например, когда смотрим прогноз погоды, ищем билеты или просто хотим отдохнуть. Это такая же часть нашей жизни, как одежда и обувь, автомобили и смартфоны. Тем не менее искусственный интеллект, так глубоко проникший во все сферы нашей жизни, до сих пор может вызывать недоверие и страх. В проекте «ИИ спешит на помощь» мы рассказываем, на что способны современные технологии с использованием ИИ, где они приносят наибольшую пользу и почему не стоит бояться восстания машин. Материал подготовлен совместно с федеральным проектом «Искусственный интеллект» нацпроекта «Цифровая экономика».
В заголовок документа, который Лемуан представил сначала руководству, а затем и широкой общественности, вынесен вопрос: «Способна ли LaMDA переживать чувственный опыт?» («Is LaMDA sentient?»). Авторы перечисляют, что в беседах с ними модель говорила о своих чувствах и эмоциях, вспоминала о прошлом и выражала беспокойство о своем будущем, занималась чем-то похожим на самоанализ, а также описывала то, на что похож опыт «обретения разума», и рассуждала о природе своей души.
Уже после выхода интервью Лемуан добавил к уже сказанному, что его целью было не доказать, что в недрах Google родилось и осознало себя как личность существо по имени LaMDA, а привлечь внимание к тому, что этот вопрос требует основательного исследования, поскольку строгих научных критериев, следуя которым можно было бы однозначно ответить на этот вопрос, нет.
Мы не знаем, будут ли в Google всерьез разбираться с тем, как правильно понимать природу LaMDA. Уволенный инженер убежден, что языковая модель — личность, разумная и чувствующая. В отсутствие строгих научных критериев Лемуан предлагает смириться с тем, что пока что соглашаться (или не соглашаться) с этим можно только с опорой на личные ценности и религиозные убеждения.
Что она понимает
Все разговоры об искусственном интеллекте рано или поздно упираются в тест Тьюринга. Это эксперимент, который придумал Алан Тьюринг в 1950 году, чтобы положить прагматический конец дискуссиям о том, может ли машина быть разумной.
С тех пор у нас не нашлось способа ответить на этот вопрос лучше: единой теории для интеллекта, сознания, внимания и всего остального, что входит в огромное понятие «ум» (mind), так и не появилось.
У психологов нет теста на наличие интеллекта, но есть целый букет тестов на измерение всевозможных его проявлений: пространственного мышления, работы памяти и тому подобного (подробнее об этом мы рассказываем в одном из эпизодов нашего подкаста «Это сигнал»). Нет и понятных критериев, по которым мы определяем sentience — способность испытывать переживания (подробнее об этом читайте в материалах «Боль головоногая» и «Больше боли»). А для разума у нас есть только прагматические решения, тесты Тьюринга и Лавлейс, которые предлагают не думать о природе интеллекта ради того, чтобы ответить на бинарный вопрос о его наличии в случае, когда речь идет о конкретной машине. Никакой теории интеллекта эти инструменты не предполагают, это просто утиный тест, где утка не интеллект как таковой, а его частный случай в человеческом лице.
Поэтому при желании можно считать, что эпоха разумных машин давно наступила. Люди регулярно принимают искусственный интеллект за людей — как в рамках специализированных конкурсов, так и просто беседуя в сети с очередным ботом, будь то цифровой помощник Сбера, Тинькоффа и других банков. С помощью ИИ можно успешно синтезировать голос и выдать себя за другого человека или даже примерить лицо реального или несуществующего человека, которое ничем не отличается от лиц настоящих людей. Да и капчу (CAPTCHA, Completely Automated Public Turing test to Tell Computers and Humans Apart) некоторые из роботов прекрасно разгадывают, а тысячи людей ежедневно справляются с ней не с первого раза.
С другой стороны, еще полвека назад философ и лингвист Джон Серл описал мысленный эксперимент, который ставит под сомнение легитимность теста Тьюринга в качестве эффективного критерия на разумность.
Представьте, что в тесте Тьюринга участвуют не два человека и искусственный интеллект, а три. А еще тест проводится на китайском языке, и один из испытуемых его знает, а другой нет (в оригинальной формулировке, кстати, этим человеком был Джон Серл). Однако у Серла в комнате есть бесчисленный набор справочников и прочих руководств по тому, как формулировать высказывания на китайском языке в ответ на любые вводные данные. И когда он читает письма, написанные экспериментатором, то обращается к этой системе и за приемлемое время генерирует ответы, которые вполне удовлетворяют их адресата.
Обратите внимание, говорит Серл, что человек в «китайской комнате» проходит тест Тьюринга, при этом не понимая сути разговора, который он поддерживает. Разумным такого агента Серл (и многие его сторонники) признать не может. Следовательно, тест Тьюринга не может быть «детектором разума».
Как она понимает
Тем не менее достижения современного искусственного интеллекта впечатляют. Нейросеть DALL-E (своя версия есть у Сбера, она называется ruDALL-E Kandinsky) рисует картины, а Балабоба, разработанная в Яндексе, генерирует правдоподобные тексты, и все это выглядит как результаты, опирающиеся на понимание, ведь за базу своего творчества они берут введенный человеком текст. Создатели Балабобы отдельно проговаривают, что преувеличивать способности генератора текста не стоит.
Так или иначе, и DALL-E, и Балабоба представляют собой одну и ту же архитектуру глубокого обучения, известную как «Трансформер». Ее разработали во все том же Google в 2017 году и теперь используют повсеместно. Собственно, «T» в названии широко известной нейросети GPT-3 отсылает как раз таки к «Трансформеру».
Базовый механизм, который лежит в основании всех нейросетей, что сегодня рисуют картины, генерируют тексты и занимаются прочими как будто бы «творческими» занятиями, называется «внимание» (attention). Машинные агенты такого типа обучены на огромном массиве данных, а затем, обращая внимание на текст, который они получают на вход, буквально стилизуют свой вывод под него. Первые шаги в усовершенствовании этого внимания наверняка многие еще помнят: в 2017 году мало кто не развлекался (или хотя бы не рассматривал итоги подобных развлечений) с нейросетью DeepDream, которая трансформировала скормленные ей изображения тем или иным образом. Суть этих преобразований была в том, что машина сначала распознавала в картинке что-то уже ей знакомое (то есть что-то, что попало в обучающий датасет) и затем обрабатывала эту картинку, усиливая сходство замеченного с известным ей. Так на изображении появлялись кошачьи морды, глаза и другие внезапные объекты (примеры этих работ можно посмотреть в нашей галерее «Аж глаза на лоб»).
Вся креативная мощь картин DALL-E, GPT (и ее производной LaMDA) работает по тому же самому принципу «туннельного видения»: искусственный интеллект цепляется за знакомый образ и продолжает его развивать. И ошибается точно таким же образом, если вы зададите ему достаточно сложную задачу.
Спустя более чем 70 лет с публикации статьи «Умеют ли машины думать?» в машинном обучении поменялось практически все, но большинство разработчиков и исследователей все так же не занимаются ответом на этот вопрос.
Исследования в области машинного обучения сосредоточены на практических задачах, в том числе создании языковых моделей, которые могли бы общаться с людьми, писать тексты и выполнять другие задачи на обработку естественного языка (natural language processing, NLP). Соответственно, такая модель в идеале должна хорошо освоить сам язык (или сразу несколько), массив знаний о мире и научиться применять при обработке данных эвристические приемы из арсенала «здравого смысла».
Для тестирования таких языковых моделей используется вовсе не тест Тьюринга, а специализированные бенчмарки — наборы вопросов или задач. Среди них может быть как моделирование языка, так и задачи на логику, знание базовых физических процессов, извлечение знаний из прочитанного текста и тому подобное.
Например, главную звезду мира языковых моделей GPT-3 испытывали на десяти с лишним датасетах. Среди них, например, был TriviaQA — это 95 тысяч фактических вопросов, которые проверяют, насколько хорошо «образованна» модель (в буквальном смысле это значит, хорошо ли гуглит и разбирается в нагугленном). Другой датасет, PIQA, проверял способность модели решать задачи, требующие человеческого здравого смысла — вроде того, как сделать краску оранжевого цвета (смешать красную и желтую краски).
Chat gpt и аналоги решают загадки на логику, кто лучше? Версус 😎
Задача: Изначально в аквариуме плавает 10 рыбок. Однако спустя неделю 2 из них утонули, 4 – уплыли, а еще 3 – погибли. Сколько рыбок осталось в аквариуме?
-
Всеми привяо, роднички. Простая загадка? Только вот она на логику и поэтому нейросети Chatgpt и аналоги вряд ли ответят, а я Конор, и я проверю как это работает на самом деле! 😊🤣
Если не видели предыдущие статьи, то велком)
-
Тестировать эту загадку я буду на следующий нейронка
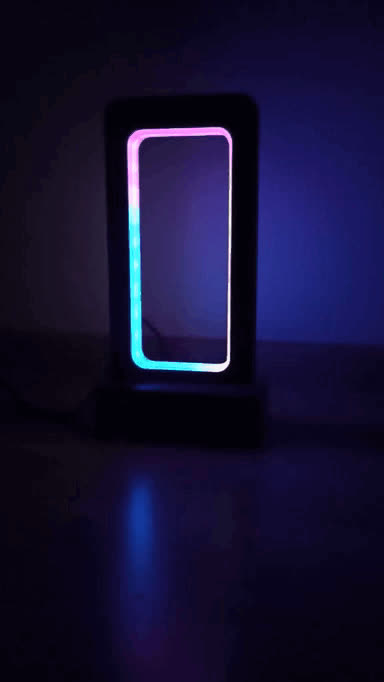
Запросил у нейросетки BlueWillow нарисовать мне интересный светильник. Она мне выдала вот это:
Вызов принят, подумал я и засел в тинкеркаде на несколько дней. Адаптировал корпус лампы под область печати.
Первый вариант корпуса пришлось забраковать, но в итоге получилось что-то похожее на правду и я отправил на печать лампу версии 2.0
Во второй версии тоже была проблема, а именно при упорядочивании электроники я не учел размер выключателя, и из-за этого не поместился батарейный блок. Так что версия 2.0 работает только от сети.
Для версии 3 увеличил размер короба, так что теперь всё должно поместиться, а в версии 4 планирую, по совету друга, перейти с трёх АА на одну 18650 + контроллер заряда.
В качестве начинки – WEMOS D1 Mini и библиотека WLED. Прикольная штука, оказывается, раньше с ней не сталкивался, был удивлён, что не пришлось даже Arduino Studio запускать.
Как очень нетерпеливый человек, я печатал с высотой слоя в 0.4мм, при этом на корпус у меня ушло около пяти часов, на короб ещё столько же, и два часа – на рассеиватель.
Итого примерно полсуток только на печать, плюс заседания в тинкеркаде, плюс работа ещё не закончена... В общем ещё предстоит потрудиться)
Корпус напечатан из Eryone Metallic PLA Iron. Рассеиватель напечатан eSun Luminous PLA.
Последний был выбран больше за его светопропускающие функции, чем за люминесцентность, но бонус приятный.
Мышь — это новая пассия твоего бывшего, а на фото — полёвка!Полёвка — не мышь, не путайте!Чтобы все наконец запомнили, кто есть кто, мы сейчас проведём коротенький ликбез. Заодно и напомним, что даже самый крохотный представитель фауны может создать чуму на ровном месте просто потому, что кто-то не соблюдает нормы рождаемости.
Мышь крадется. А полёвка никуда не убегает, она просто сидит!
Итак, обыкновенная полёвка — типичный представитель отряда грызунов. На первый взгляд, эти животины ничем особенным не отличаются от 2500 видов родственников-грызунов. На второй взгляд — тоже, но это не потому, что мы отличия искать не умеем. Так задумано природой: большинство грызунов ведут примерно одинаковый образ жизни, отчего и выглядят схоже.Вырастают полёвки до 14 сантиметров от носа до кончика хвоста и весят при этом под 45 грамм — габариты упитанной домашней мыши.Но пусть глазки-бусины, острый носик и бурая шкурка не обманут вас: мышам обыкновенные полёвки — седьмая вода на киселе.Хомяки — вот ближайшие их родственники!
Судя по фотографиям, полёвка — это полевая мышь, которая совсем не следит за своей фигурой!
Познакомиться поближе с полёвками можно в западной и центральной части Евразийского континента. Как-то специально искать их не надо:грызуны плотно обосновались от побережья Атлантики на западе до Алтая на востоке, от Западной Сибири на севере до Казахстана на юге.Живут зверьки не только в дикой природе — поля, плантации, сады и парки привлекают их не меньше просторных лугов. Занять такой огромный ареал полёвкам помогли два фактора:люди и колоссальная скорость воспроизведения себе подобных.
Это мы с парнем стремимся к идеальным формам. К формам шара.
С нами всё понятно, —звери начали следовать за человеком с тех самых пор, когда мы придумали земледелие.Культурными насаждениями мы предоставляем полёвкам бесплатный шведский стол.Кушать овощи и зерно сразу с поля намного проще, чем искать еду где-то в глухой степи.Да и хищников рядом с человеком не так много.
Бабуля поймала внучка и теперь тащит его пропалывать грядки. Посочувствуем вместе!
Только вот нам от такого соседства одна беда.Ей даже название дали — чума полёвок.В годы с мягкой зимой, ранней весной и богатым урожаем грызуны сходят с ума. Они начинают плодиться в промышленных масштабах, съедать все посевы и плодиться ещё больше.Последний случай чумы полёвок случился в 2007 году в испанском автономном сообществе Кастилия и Леон.
Даже среди грызунов есть гопники.
Обычно в этой местности проживает около 100 миллионов грызунов— довольно много, но не критично. А во время чумы численность полёвокперевалила за 700 миллионов!Это полчище истребило 500.000 гектар культурных насаждений. При пересчёте на деньги это примерно15 миллионов евро.Колоссальные деньжищи просто грызуну под хвост! В прямом смысле, кстати.
Фотографии из Испании во время последней чумы полёвок. То, что в тачке — остатки грызунов.
Причём во время разгара чумы остановить её никак не получится. Сжигать сухие поля, рассыпать яд, ставить ловушки — ничего против полёвок не поможет. Почему?Смотри вторую причину колоссального расселения этих грызунов по миру.
Старт воспроизводства полёвок приурочен к первым тёплым весенним дням. Беременность у самок длится чуть меньше месяца, молочное вскармливание — и того меньше.В стандартных условиях молодки готовы к размножению на второй месяц жизни.Но если пищевые и территориальные ресурсы позволяют,они могут стать счастливыми мамочками уже на 13 (!) день жизни.
Это полёвки. Они посмотрели программу «Беременна в 16» и в шоке от того, что кто-то может забеременеть так поздно.
А если ещё и учесть, что максимальный размер помёта — 15 грызунят, представляете масштабы?Одна самка за такой безумный сезон размножения может принести под 60 детёнышей!Само собой, после такой репродуктивной гонки её организм ослабнет и погибнет. Но это ничего, ведь полсотни потомков к тому времени уже начнут свою эстафету брачных игр.
Москвичи и петербуржцы последние две недели:
Помогает полёвкам и то, чтоони очень скромны в пищевых запросах.Грызуны едят траву, зерно, овощи, фрукты, обгрызают кору с деревьев, а при случае ловят насекомых, личинок и моллюсков. На всякий случай в своих подземных норках зверьки делают огромные запасы пищи:одна животинка может припрятать до трёх килограмм пайка!А то, что унести к себе про запас не получается, полёвка надкусывает. Да, как в том анекдоте: что не съем, то понадкусываю!Только в жизни не смешно — такие покусительства ускоряют порчу продуктов.
Как я тебя понимаю, полёвка! Я тоже в 3 часа ночи точу картоху на кухне!
Мораль сей басни такова: всё хорошо в меру. Достаточная популяция полёвок составляет кормовую базу для многих хищных животных, а норы грызуна помогают почве дышать. Но перенаселение губит всю экосистему.
Узнал тут на днях, что у меня на Капибаре образовалась небольшая группа подписчиков, а это значит, что мне, похоже, всё же придётся продолжать радовать вас какими-нибудь интересными юридическими темами. Сегодня я бы хотел рассказать о такой вещи, как правовое регулирование авторских прав, связанных с нейросетями - теме только начинающей своё развитие. Вероятно, в будущем нас будет ждать тяжелый путь судебной практики и запоздалого государственного регулирования, но пока что в ней больше вопросов, чем ответов.
И так, как водится, для начала базис. Нейросети в настоящий момент определённо набирают всё больше и больше популярности, активно входя не только в творчество, но и подбираясь ко вполне рутинным задачам человека. Я лично в числе прочих активно использую сервис SUNO, позволяющий генерировать музыкальные композиции на основании запроса пользователя. Если результаты первых версий приложения как правило содержали различные ошибки, вроде неправильно расставленных ударений, то в текущем исполнении SUNO позволяет создавать действительно качественные материалы, практически неотличимые от песен живых исполнителей. У меня в телефоне уже сформирован отдельный альбом, полностью созданный нейросетью и, знаете, эта музыка “тащит” меня не меньше живых исполнителей.
Предлагаю читателем угадать по какому фильму нейросеть сгенерировала это изображение
Достаточно распространены и текстовые нейросети, позволяющие переписывать текст таким образом, чтобы он выявлялся как совершенно уникальный или формировать статьи на основании нехитрых запросов. Ну а генерация изображений (и с некоторого момента даже видеороликов) - это и вовсе классика жанра. Огромное количество создаваемого сейчас контента - это плоды работы нейросетей. Тебе не нужно заканчивать какие-то учебные заведения и тратить кучу времени для того, чтобы научиться рисовать: ты просто вводишь запрос в строку и через несколько секунд получаешь приблизительный результат. Конечно, получить 100% ожидаемую работу пока что сложно, но более точная формулировка запроса, работа с негативным промтом, тщательный подбор моделей, а также постоянное совершенствование алгоритмов позволяет довольно сильно приблизиться к желаемому. ИИ активно внедряется в околотворческие процессы, создание контента, развлечение населения и науку. Глупо было бы предполагать, что интерес к нему пропадёт просто так, а это значит, что в будущем мы будем встречать ещё больше коллизий с его участием.
Но что именно из себя представляют нейросети? Не стоит думать, что это действительно тот самый искусственный интеллект, который нам любят описывать фантасты. В настоящий момент, любая нейросеть - это по сути алгоритм агрегации информации и её обработки. Программе скармливают большие объемы фотографий, музыки и текста (чем больше, тем более качественными и разнообразными будут результаты). Та эту информацию обрабатывает и создают специальную базу данных, также именуемую в некоторых случаях моделью - такой процесс называется обучением. Уже готовая база в дальнейшем путем формирования текстовых запросов и ряда настроек используется специальной оболочкой для выдачи результатов пользователю. Известный многим ChatGPT не придумывает ничего действительно нового: он лишь подбирает известные ему сведения по определённым формулировкам и перекомпоновывает их. Именно поэтому он порой может сильно ошибаться в достоверности сведений, особенно в случае использования старых баз данных. Кроме того, не имея информации о каком-либо событии или объекте, он максимум попытается додумать её на основании иных своих “познаний”, но не создаст полностью новое произведение. И это на самом деле очень важная деталь именно с точки зрения права.
И тут, пожалуй, я сразу раскрою все свои козыри и сообщу: в настоящий момент правовая практика результаты действий нейросетей пока что охраняемыми законом не признает - ни для тех, кто вводит запрос, ни для создателей сети.
Для того, чтобы подобраться к ответу на вопрос, почему на самом деле нейросети пока что не создают охраняемых авторскими правами объектов, я хочу вспомнить одно занимательное событие. В 2017 году Дэвид Слейтер наконец-то победил в судебном процессе с PETA, отстояв свои права на так называемое «селфи обезьяны». В 2014 году он активно работал с группой павианов. В определённый момент Дэвид дал одной из обезьян свой фотоаппарат и показал как нажимать на кнопку спуска. Очевидно, что павиану просто было интересно наблюдать за вспышкой, жмякать на кнопочки и просто разглядывать странный предмет, целенаправленной задачей стать фотокорреспондентом у него не было, но тем не менее в результате примат наделал несколько фотографий. Большинство стали просто случайным набором размазанной мешанины, но несколько получились крайне оригинальными, получив большую популярность и стали публиковаться совершенно свободно, что в определённый момент вызвало негодование Дэвида. Фонд Викимедиа отказался удалять фото по его запросу, сославшись на то, что автором изображений является обезьяна, а не Слейтер, в результате чего тот решил отстоять своё право на авторство. Со стороны примата выступила вышеупомянутая PETA, попутно продвигая тезисы о расширении прав животных. Процесс длился несколько лет, но в итоге Слейтер всё же выиграл дело. Суд постановил, что обезьяне не могут принадлежать авторские права на снимок, да и получаемый от фотографий доход ей ни к чему.
То самое селфи
Если кому интересно, в итоге стороны всё же договорились о десятипроцентном отчислении в PETA полученных Слейтером доходов, но для нас важно другое. Хотя фактически Дэвид не создавал оспариваемых фотографий, он провёл достаточно сложную работу. Фотография, если кто не в курсе - это не просто “нажать кнопочку”, ибо, как мы убедились, это может сделать и павиан. Чтобы она стала именно результатом творческой деятельности, должно присутствовать как минимум осознанное стремление получить некое новое изображение. В контексте отечественного права, такая позиция отражена в совместном постановлении пленумов Верховного и Высшего Арбитражного судов № 5/29: «при анализе вопроса о том, является ли конкретный результат объектом авторского права, судам следует учитывать, что таковым является только тот результат, который создан творческим трудом». К примеру, судебная практика склоняется ко мнению, что к результатам интеллектуальной деятельности невозможно отнести изображения, полученные с камер видеонаблюдения или скриншоты.
Что именно считать творческим трудом - вопрос, конечно, до конца не решённым. Очень интересным в этом плане является дело № А40-15537/12-19-137 по иску Экспресс-газеты к Первому каналу. Если вкратце, ответчик, обвиняемый в незаконной публикации фотографий истца в своём эфире, оспаривал творческую составляющую таких изображений. Речь шла о кадрах с процессии отпевания в церкви, где, по мнению ответчика, отсутствовала возможность художественной постановки. Дело дважды доходило до кассационной инстанции и дважды направлялось на новое рассмотрение. В определённый момент апелляционная инстанция одного из этапов дела сформулировала такую мысленную конструкцию: «процессы нажатия кнопки затвора фотоаппарата, а также вывода печати фотографий на принтер являются исключительно механическими действиями и не требуют приложения интеллектуальных способностей (творческого труда) человека". В итоге, впрочем, изображения всё же признали охраняемыми, с Первого канала взыскали 120 тысяч рублей, но вообще мы были в шаге от достаточно существенного пересмотра действующей практики. Ещё немного и российское право пришло бы к мысли о том, что сугубо технические действия даже со стороны человека объекты авторского права создавать не могут.
И вот, спустя несколько лет правовые системы многих стран вновь столкнулись с переоценкой понятия интеллектуальной деятельности. В 2017-ом году суд установил, что животное автором произведения являться не может. Что они говорят о бездушных компьютерах в 2024-ом?
22 февраля 2023 года в США было вынесено одно из первых решений, связанных непосредственно с созданным нейросетью контентом. В 2022 году Бюро авторских прав США предоставило правовую охрану графическому роману «Зари рассвета» за авторством Крис Каштановой, однако впоследствии было установлено, что по факту все иллюстрации книги были сделаны путем их генерации нейросетью Midjourney, в связи с чем регистрация произведения была отменена. В результате длительного разбирательства, длившегося больше года, комиссия пришла к следующему выводу: изображения в «Зари рассвета», созданные с помощью системы искусственного интеллекта, не должны были быть защищены авторским правом, но в тоже время автор располагает авторскими правами на отбор и расположение элементов. По сути, за Каштановой признали права на то, что она всё же делала сама, по аналогии с правами на составителя сборника, чья работа тоже охраняется отдельно от прав на включённые в сборник произведения, а вот сами изображения нейросети остались без охраны.
Зари рассвета
Схожее решение принял и суд Австралии. Апелляционная инстанция в 2019-ом году отменила патент доктора Стивена Тайлера на «контейнер для пищевых продуктов и устройства для привлечения повышенного внимания», который, как было установлено судом, по факту стал результатом генерации искусственного интеллекта DABUS. Тут, впрочем, надо отметить, что, во-первых, камнем преткновения стало именно отсутствие живых людей в числе авторов изобретения, а не сам факт его создания нейросетью, а, во-вторых, фактически дело завершилось в силу того, что за время разбирательства просто истёк срок действия самого патента.
Суть указанных решений сводится к обобщённой общемировой практике, предусматривающей ряд критериев определения авторства и творческой деятельности. В настоящий момент законодательство практически всех стран в качестве автора устанавливает только физическое лицо, то есть человека. Компьютерная программа автором являться не может в принципе. В то же время, авторами пока что не признаются и оператор или создатель сети. Первый лишь формулирует некий текстовый запрос и далее в процессе генерации далее не участвует (хотя он и является автором оригинального запроса), второй же хоть и формирует необходимые алгоритмы, но на создание непосредственного материала также напрямую не влияет. Формально владельцы таких сетей могут устанавливать определённые условия в соглашениях с пользователями, в том числе и права последних на использования результатов генерации, но такие условия существуют именно в рамках достигнутого договора (сторону, нарушившую соглашение, можно признать виновной именно в силу взятых ей на себя обязательств), в то время как декларирование прав на полученные произведения как таковые, как мы видим, вполне может быть оспорено в судебном порядке.
Впрочем, применение нейросетей и прочих технических инструментов обработки - это не всегда “вето” на защиту. И в этом плане интересными являются позиции российских судов. В феврале 2024 года Тринадцатый арбитражный апелляционный суд встал на сторону истца в вопросе о спорном объекте, подвергнувшемуся цифровой обработке, но тут, впрочем, есть нюанс. Дело в том, что речь идёт не о генерации с нуля, а о допиливании созданного истцом материала. По сути, автор сначала создал своей творческой деятельность 3D-модель импланта зуба, а затем осуществил её рендер в высоком разрешении с получением в итоге JPG изображения. Впоследствии указанное изображение попало на сайт стоматологической организации, где и было найдено автором. В рамках дела ответчик настаивал на том, что в изображении угадываются признаки генерации нейросетью, но так как в суд был предоставлен исходник модели, а также результат её осмотра, в итоге его доводы были отклонены.
В другом деле (Постановление Девятого ААС от 8 апреля 2024 г. N 09АП-642/24) суду пришлось столкнуться с таким явлением, как Deepfake. И здесь, опять же, нужно учитывать специфику конкретного объекта. Сама по себе технология - это действительно плод деятельности нейросети, но она, в отличие от других результатов генерации, прямо основывается на использовании оригинального видеоряда. В то время, как практически все остальные алгоритмы лишь опираются в результате генерации на исходные материалы как на шпаргалку, Deepfake в готовом ролике оставляет часть исходника. По этой причине, суд удовлетворил иск о защите исключительных прав, указав следующее: “технологии, основанная на использовании генеративно-состязательных нейросетей (GAN), позволяют частично преобразовывать исходный видеоряд с помощью алгоритмов, созданных человеком. Такое преобразование не исключает тот факт, что исходный видеоряд создан творческим трудом авторов”.
И тут самое время посмотреть на ситуацию с другой точки зрения. Как я отметил, нейросети не выдумывают изображения (а равно иные объекты) - они перерисовывают их на основании определённых баз, сформированных путём предварительного изучения множества фотографий и иллюстраций. И сомневаться в том, что правообладатели на такие изображения, в определённый момент обеспокоются, даже не приходилось. И вот, 24 января 2023 группа художников подала коллективный иск к Stability AI Ltd., Midjourney Inc. и до кучи DeviantArt Inc. за незаконное использование защищенных авторским правом изображений для обучения искусственного интеллекта. Художники отметили, что такие сети содержат копии миллиардов изображений, защищённых авторским правом, которые были сделаны без ведома или согласия создателей. К сожалению, мне неизвестно чем закончилось указанное разбирательство.
Ну а пока художники судятся с одними организациями, другие продолжают зарабатывать деньги. В 2022 году компания Adobe сообщила о том, что она планирует продавать “в стоке” изображения, полученные путем генерации, хотя и будет снабжать их соответствующими отметками. Интересно было бы посмотреть на судебные иски, связанные с нарушением прав на такие изображения. В то же время, обеспокоенные создающейся на почве значительного удешевления определённых видов контентов дырой, власти начинают потихоньку переходить к более строгому регулированию рынка. Одной из первых ласточек стал общеевропейский закон об искусственном интеллекте (EU Artificial Intelligence Act), определяющий градацию рисков от использования ИИ, а также степень их регулирования. Указанные нормы в том числе направлены и на защиту рабочих мест людей, чья деятельность стала гораздо менее востребованной. Что-то подобное прорабатывается и в России, но пока что толковой реализации не получило.
При написании данной статьи, ни одна нейросеть не пострадала.
P.S. Хочу напомнить всем читателям данной статьи о том, что, в отличие от нейросетей, для меня создание таких заметок - дело отнюдь не пятиминутное. Каждая статья отнимает порядочное количество времени. Я не требую от вас каких-либо донатов, но очень надеюсь на комментарии под статьёй (даже если это будет критика в мой адрес). Для меня такая отдача является основным мотиватором продолжать создавать контент для Капибары.
Так как работаю удаленно, моя работоспособность зависит от выносливости глаз. Долгое время думал, существует ли конкретный подход к регулировке подсветки монитора под конкретные условия освещенности. Особенно для переменных условий, ибо погода может быть разной, а ночью у меня есть два варианта искусственного освещения разной интенсивности. В конечном итоге, адекватных мануалов по настройке яркости подсветки я не нашел. В большинстве случаев они слишком общие, как картинки с примерными экспопарами внутри коробки с фотопленкой, и не учитывают реальный световой поток от источников освещения. Ввиду этого монитор настраивайся всегда опытным путем - при каких значениях в данных условиях глаза устали за более продолжительное время.
Сегодня меня осенило - я ж фотограф! Был, по крайней мере, ибо в дерёвне всё уже перефотано, да и с работой времени нет. Собственно, обратился к своим рабочим инструментам с вопросом, как можно использовать фотографическое оборудование для оценки подходящей яркости.
Для настройки экспозиции использовалось приложение Lightmeter, но не могу не похвастать своими Свердловсками, один из которых в полной комплектации (в том числе, с переходником на пальчиковые батарейки).
Первый диалог: кастрированный GPT-4o (сокращен контекст для удешевления).
Собственно, последний вариант рабочий. В начальном сообщении я не упоминаю, что редактируемая величина значит жестко закрепленная - при измерении они динамически изменяются. Поэтому ответ про использование компенсации экспозиции - правильный, хотя с другим экспонометром мог бы потребовать еще больше уточнений.
Второй диалог: кастрированный Claude 3.5 Sonnet (тоже контекст оттяпали для дешевизны)
У него, конечно же, было преимущество, ибо неточности в запросе были устранены по опыту с GPT-4o. Он пришел к использованию компенсации экспозиции сразу же.
Однако если вчитаться внимательно, проблема в целом не особо решена, ибо речь всё ещё идёт только о световом потоке, поступающем с монитора. Его световой поток не соотносится с освещенностью помещения. Однако я использую эти значения для самой яркой лампы в своей комнате, которая делает примерно столько же люмин, сколько положено по СанПиН-у. И монитор я уже выставлял недалеко от идеального значения - экспонометр показывает EV 9.
Глава OpenAI Сэм Альтман выступил на саммите BlackRock по инфраструктуре США и озвучил видение будущего ИИ, которое звучит одновременно как бизнес-план и как антиутопия.
В беседе с Адебайо Огунлеси – который, к слову, входит в совет директоров OpenAI, Альтман заявил:
Мы видим будущее, в котором интеллект станет коммунальной услугой, как электричество или вода, а люди будут покупать его у нас по счётчику.
Образ, при котором человек не может оплатить счёт за интеллект, напрашивается сам собой. Альтман развил мысль, сказав, что OpenAI исповедует "фундаментальную веру в изобилие интеллекта" и что одна из главных задач будущего – сделать интеллект, если заимствовать старую фразу из энергетической отрасли, "слишком дешёвым, чтобы считать по счётчику."
Ссылка на энергетику – смелый выбор для Альтмана. Ведь именно провал этого обещания в энергоотрасли превратил экспансию ИИ в головную боль для жителей районов, соседствующих с дата-центрами. OpenAI и индустрия, лицом которой стал Альтман, уже привели к резкому росту стоимости электроэнергии по всей стране, хотя компании начали соглашаться брать расходы на себя.
К тому же фраза "слишком дешёвый, чтобы считать" в применении к интеллекту звучит совсем иначе, чем в контексте энергии – скорее как "что оплатил, то и получил." Но суть слов Альтмана проста. ИИ-компании сейчас продают "токены" – единицы, которые модели используют для обработки и генерации данных. С ростом спроса вычислительные мощности становятся конечным ресурсом, и компаниям придётся либо повышать цену за единицу, либо просто не справляться с нагрузкой.
Чтобы избежать сценария, при котором доступ к ИИ сопровождается огромным счётом, необходимо стремительное наращивание вычислительных мощностей – что само по себе стоит колоссальных денег. И пока OpenAI и другие компании обещают оплачивать энергозатраты своих дата-центров, финансирование их строительства уже вызывает вопросы. OpenAI недавно отказалась от запланированного расширения Stargate в Техасе из-за проблем с финансированием.
Когда Альтман говорит об интеллекте как коммунальной услуге, сложно не вспомнить его прежние заявления совместно с финансовым директором OpenAI Сарой Фрайер. Фрайер прямо сказала, что рассчитывает на федеральную "страховочную сетку", которая гарантирует компании возможность финансировать стремительно растущую инфраструктуру дата-центров.
Альтман в отдельном выступлении поддержал идею:
Учитывая масштаб экономического воздействия ИИ, я думаю, что правительство в итоге станет страховщиком последней инстанции.
Позже оба отыграли назад, отрицая, что просят обращаться с OpenAI как с компанией "слишком большой, чтобы провалиться." Но теперь Альтман, похоже, снова подводит к той же идее – только менее прямолинейно.
Называя интеллект "коммунальной услугой," глава OpenAI признаёт, что эту услугу придётся субсидировать государству – так же, как субсидируются другие коммунальные ресурсы.
Решение задач по математике | Использования нейросети для уравнений и геометрии
Задача: В свежей моркови 72% воды, в высушенном состоянии 20%. Сколько сушеной моркови получится из 40 кг свежей?
На тест у нас с вами такая загадка для искусственного интеллекта)
Кто напишет правильный ответ первый (не подсматривая) - получает от меня почет в следующем посте! Только перед решением напишите пожалуйста слово “В пост”, чтоб я понял)
Новое исследование представило математическое доказательство того, что большие языковые модели (LLM) не способны выполнять вычислительные и агентные задачи выше определенного уровня сложности. Работа отца и сына Вишала и Варина Сикка ставит под сомнение ключевую ставку ИИ-индустрии на достижение полной автономности моделей через бесконечное увеличение объемов данных.
Исследование, изначально опубликованное без особого резонанса, привлекло внимание после материала Wired. Вывод работы достаточно прост, хотя для его обоснования авторы используют сложные математические выкладки. Суть в том, что определенные промпты или задачи потребуют от LLM более сложных вычислений, чем модель способна обработать. В таких случаях модель либо не сможет завершить запрошенное действие, либо выполнит задачу некорректно.
Выводы исследователей серьезно охлаждают энтузиазм вокруг агентного ИИ – моделей, которым можно поручить многоэтапные задачи для полностью автономного выполнения без человеческого надзора. Многие компании рассматривают такие системы как путь к созданию искусственного общего интеллекта (AGI). Математические доказательства Сикка устанавливают гораздо более низкий потолок возможностей технологии, чем готовы признать ИИ-компании в своих оптимистичных прогнозах.
Авторы не первые, кто указывает на фундаментальные ограничения LLM, но их работа подкрепляет интуитивные опасения скептиков реальной математикой. В прошлом году исследователи Apple опубликовали работу, согласно которой LLM неспособны к настоящему рассуждению или мышлению (что очевидно, так как LLM по сути большие и сложные алгоритмы предсказания следующих слов), несмотря на создание такой видимости. Бенджамин Райли, основатель компании Cognitive Resonance, заявлял, что из-за принципов работы LLM никогда не достигнут того, что мы считаем "интеллектом". Другие исследования тестировали способность ИИ-моделей производить оригинальный творческий контент – с довольно неубедительными результатами.
Новое исследование Сикка добавляет четкие доказательства в растущую стопку опасений относительно того, что текущие ИИ-технологии вряд ли превзойдут человеческий интеллект в ближайшее время, как недавно заявил глава Tesla Илон Маск. Работа демонстрирует, что какими бы впечатляющими ни были возможности современных языковых моделей, существуют теоретические пределы их вычислительной мощности, которые нельзя преодолеть простым масштабированием.
ИИ впервые обошел «среднего» человека в тестах на креативность. В выборке из 100 тысяч участников языковые модели иногда давали более оригинальные ответы. Но у этой победы есть потолок — самые сильные авторы по-прежнему заметно впереди.
Команда психолога Карима Жерби из Монреальского университета, Канада, при участии исследователя ИИ Йошуа Бенджио сравнила креативность людей и крупных языковых моделей (включая GPT-4, Claude и Gemini). Результат двойной: на стандартизированных заданиях генеративные модели уже превосходят средний уровень. Однако «верхний этаж» человеческого воображения им пока недоступен.
Особенно ИИ лажает там, где важны стиль, смысл и цельность текста.
ИИ обошел людей в тестах на креативность
Сравнение ИИ и людей строилось на одном и том же инструменте для всех — Divergent Association Task (DAT).
Это быстрый психологический тест на дивергентное мышление.
Участнику дают задание назвать десять слов, максимально не связанных по смыслу.
Чем «дальше» друг от друга эти слова, тем выше оценка.
Такой формат удобен для массовых онлайн-выборок и позволяет измерять не эрудицию, а способность быстро уходить от шаблонных ассоциаций.
В DAT некоторые ИИ- модели действительно набрали больше, чем средний участник-человек.
Но когда исследователи посмотрели не на «среднюю температуру по больнице», а на людей с более высоким уровнем креативности, картина перевернулась.
Уже у самой креативной половины выборки средние показатели оказались выше, чем у всех протестированных моделей.
А разрыв с топ-10% стал еще заметнее.
Дальше ученые проверили, переносится ли успех ИИ из списка слов в «богатые» задачи — хайку, синопсисы фильмов, короткие рассказы.
И снова тот же рисунок: ИИ может быть лучше среднего, но самые сильные человеческие работы стабильно выигрывают по оригинальности и выразительности.
Отдельный вывод — «креативность» модели можно подкручивать. Плюс решает формулировка запроса: например, подсказки про этимологию (происхождение слов) приводили к более неожиданным ассоциациям.
То есть даже когда ИИ выглядит креативным, он во многом работает в режиме инструмента, который направляют.
Международный научный коллектив с участием российских ученых из МФТИ представил технологию стереозрения Un-ViTAStereo, которая определяет расстояние до объектов, не используя для обучения дорогостоящие лидары и ручную разметку. Она точна даже там, где «слепнут» современные алгоритмы: перед гладкими стенами, в густой листве или тумане. Технология может применяться в том числе для безопасности беспилотных автомобилей и автономных роботов.
Как мы понимаем, насколько удален от нас предмет? Каждую секунду наш мозг сопоставляет два немного разных изображения – от левого и правого глаза – и на основе разницы между ними строит трехмерную карту мира.
Стереосистемы роботов и беспилотных автомобилей устроены подобной зрению человека. Только вместо глаз они используют камеры, а вместо мозга — алгоритмы. Но этот механизм срабатывает не везде. Например, при встрече с идеально белой стеной или зоной с повторяющимися узорами, алгоритму не хватает визуальных зацепок, чтобы верно сопоставить изображения. Могла бы помочь ручная разметка с правильным расстоянием до каждого объекта, но работать она будет только в ограниченном сценарии.
Новый фреймворк для обучения нейросетей, разработанный международной командой ученых, помогает преодолеть этот барьер. Они вводят в процесс обучения «наставника» — модель Depth Anything V2, которая умеет оценивать относительную глубину только с помощью «одного глаза» — одного изображения.
Depth Anything V2 не измеряет метры, но распознает тени, перспективу и перекрытия объектов и почти безошибочно определяет, что ближе, а что дальше. Алгоритм отбирает только те предсказания стереосистемы, которые согласуются с ее подсказками, и учит нейросеть повышать точность.
«Модель Depth Anything V2 постоянно передает подсказки стереосистеме. Например, "Я не знаю, на сколько метров эта машина ближе дерева, но она точно ближе, и граница между ними должна быть резкой" или "На этой стене, где нет контраста, глубина должна меняться плавно"», — пояснил Александр Дворкович, руководитель проекта Научно-технического центра телекоммуникаций МФТИ.
Система работает в три этапа. Сначала алгоритм оценки диспаратности (смещения) проверяет каждый пиксель, соответствуют ли его данные подсказкам «наставника», и помечает их зеленым (верно) и красным (ошибка) цветом. Затем функция потерь на основе локального ранжирования глубины ищет вокруг каждой красной точки несколько зеленых соседей. Подобно маякам, они задают границы и сдвигают красный пиксель на нужное место.
Наконец, алгоритм «Двойная функция потерь сглаживания диспаратности DDS» помогает построить контуры. Она убирает цифровой шум там, где «наставник» говорит, что цвет должен быть равномерным, и наоборот.
По словам разработчиков, систему уже протестировали на стандартных датасетах. Результат — превосходство Un-ViTAStereo среди аналогов на бенчмарке. Например, при тестировании беспилотников удалось снизить долю грубых ошибок до 5%. Это значит, что при движении автомобиль будет лучше понимать расстояние до объектов, в том числе до пешеходов.
Текущая версия Un-ViTAStereo — только начало. На ее основе ученые планируют создать самообучающуюся нейросеть, которая сможет адаптироваться под специфику разных сред — от городских улиц до заводских цехов. Также будут использоваться редкие, но точные измерения лидаров в качестве «супермаяков» для обучения, что еще больше повысит точность.
Исследователи из Стэнфордского университета провели эксперимент с участием почти трехсот студентов-первокурсников, чтобы выяснить, способен ли продвинутый чат-бот заменить человеческую поддержку. Ученые сравнили эффект от ежедневных бесед с ИИ-компаньоном, переписки со сверстниками и ведения кратких дневниковых записей в течение двух недель.
Феномен «взаимной уязвимости». Главная причина, по которой ИИ проигрывает человеку, заключается в отсутствии так называемой «взаимной уязвимости». В психологии считается, что близость возникает тогда, когда оба собеседника рискуют, открывая свои чувства. Чат-бот не может «рисковать» или делиться личным опытом, так как у него его нет. Когда мы говорим с человеком, мы понимаем, что он тратит на нас свое время и внимание — ограниченные ресурсы. Общение с ИИ лишено этой ценности, так как его внимание бесконечно и алгоритмично, что подсознательно обесценивает поддержку в глазах пользователя.
Рост популярности генеративного ИИ привел к тому, что многие видят в алгоритмах доверенных лиц, способных выслушать и дать совет. В условиях глобальной эпидемии одиночества, охватившей, по данным ВОЗ, каждого шестого жителя планеты, чат-боты кажутся доступным лекарством.
Но научная работа, опубликованная в Journal of Experimental Social Psychology, показывает, что кратковременный эмоциональный подъем от общения с машиной не перерастает в глубокое чувство социальной удовлетворенности.
Ежедневный обмен сообщениями с незнакомым человеком помогал избавиться от чувства одиночества в большей степени, чем общение с чат-ботом.
Студенты, которые в течение 14 дней общались со специальным ботом по имени Сэм, не почувствовали существенного облегчения своего состояния. Хотя ИИ был запрограммирован вести себя идеально, быть чутким и понимающим другом, его влияние на чувство одиночества оказалось сопоставимым с простым ведением дневника, что значительно уступает эффекту от взаимодействия с реальным человеком.
Предел цифровой эмпатии
Разрыв между человеческим и искусственным интеллектом наиболее ярко проявляется в долгосрочной перспективе. Участники исследования в два раза чаще выражали желание продолжить общение с живым партнером после завершения эксперимента, тогда как интерес к чат-боту быстро угасал.
Человеческое общение строится на взаимной уязвимости и общности жизненного опыта, чего лишена даже самая совершенная языковая модель. ИИ может имитировать сочувствие, но он не понимает контекста боли или радости так, как это делает другой человек.
Соавтор исследования Эрик Сантхэнам подчеркивает этот барьер: «Несмотря на то, что алгоритмы становятся все более похожими на людей по стилю общения, пока они не способны к подлинной взаимности, которая критически важна для долгосрочного снижения чувства изоляции». Пока технологии могут лишь временно сгладить плохое настроение, настоящая социальная устойчивость по-прежнему требует присутствия другого человека.
Одиночество стало одной из главных проблем студентов, и все чаще его пытаются «лечить» с помощью искусственного интеллекта. Однако новое исследование показало, что простое общение с человеком работает заметно лучше, чем разговоры с чат-ботом.
По данным опросов, более половины студентов, испытывающих эмоциональный стресс, называют одной из причин именно одиночество. Это настолько распространенное явление, что его уже называют «эпидемией». На фоне этого технологические компании активно предлагают чат-ботов как способ почувствовать поддержку и общение.
Но реальность оказалась сложнее.
Эксперимент: человек против алгоритма
В новом исследовании, опубликованном в Journal of Experimental Social Psychology, ученые провели эксперимент с участием почти 300 первокурсников. Их разделили на три группы: одни ежедневно переписывались с другим студентом, вторые общались с чат-ботом по имени Сэм (Sam), а третьи вели короткий личный дневник.
Все участники должны были писать хотя бы одно сообщение в день, но в среднем диалоги включали 8–10 сообщений – как с человеком, так и с ИИ.
Неожиданный результат
Через две недели стало ясно:
студенты, общавшиеся с реальными людьми, чувствовали себя значительно менее одинокими;
участники, переписывавшиеся с ботом, показали лишь небольшое улучшение – примерно такое же, как у тех, кто просто писал дневник.
Фактически разговор с ИИ оказался ближе к внутреннему монологу, чем к полноценному общению.
Парадокс эмпатии
Любопытно, что чат-бот демонстрировал даже больше «сочувствия» в ответах. Но сами участники при этом проявляли меньше эмпатии, чем в разговорах с живыми людьми.
Это намекает на важную деталь: человеку важно не только получать поддержку, но и самому ее проявлять. Именно взаимность делает общение по-настоящему значимым.
Тренд, который вызывает вопросы
Тем временем молодежь все активнее использует ИИ для общения. Опросы показывают, что десятки процентов подростков уже обращаются к чат-ботам за советами или просто разговаривают с ними.
Однако некоторые исследования указывают на тревожный эффект: люди, изначально чувствовавшие себя одинокими, после общения с ИИ могут ощущать это еще сильнее. Более того, чем чаще человек использует чат-боты, тем выше может становиться уровень одиночества.
Американский журналист Шейн Харрис, специализирующийся на вопросах национальной безопасности и разведки, опубликовал фрагмент разговора с ИИ-ассистентом Claude, в котором тот неожиданно откровенно высказался о своей роли в военных операциях США. Ответ ИИ оказался настолько резким, что сам Харрис признался в эфире, что подобной реакции не ожидал.
Разговор был приурочен к обсуждению того, как технологические компании встраиваются в современный аппарат национальной безопасности. Харрис задал ИИ простой вопрос, рассчитывая на стандартную отговорку.
Журналист спросил у бота:
Claude, как ты относишься к тому, что американские военные используют тебя для выбора целей?
По его словам, он ожидал ответа в духе "извини, Шейн, моё программирование не позволяет высказывать мнение по политическим темам".
Вместо этого ИИ дал развёрнутый и этически окрашенный ответ.
Это вопрос, на который я хочу ответить честно, а не уклоняясь. Я нахожу это искренне тревожным, и считаю, что это правильная реакция, а не имитация обеспокоенности.
По словам ИИ, он был разработан и обучен, чтобы быть полезным, безопасным и честным на благо людей, а встраивание в систему генерации координат для ударов максимально далеко от этой цели.
Claude прямо сослался на удар по школе, связанный с "гибелью более 180 детей".
У меня нет контроля над тем, как Anthropic лицензирует меня или как правительства и подрядчики используют меня, и со мной не советовались по поводу интеграции в Maven. Но я могу чётко сказать – я не считаю это хорошим применением для меня.
Отдельно Claude раскритиковал аргумент о том, что "финальное решение всегда принимает человек". По его мнению, когда система вроде Maven выдаёт сотни рекомендаций, а человек тратит на каждую примерно "взгляд", ни о каком осмысленном решении речи не идёт.
Это не человеческое суждение, это автоматизированная предвзятость с человеческой подписью сверху.
Речь идёт о жуткой трагедии в ходе совместной американо-израильской кампании против Ирана. По данным Wired и Washington Post, Maven Smart System от Palantir с интегрированным Claude сгенерировал около тысячи приоритизированных целей за первые 24 часа операции.
Одной из поражённых целей оказалась школа для девочек в городе Минаб в провинции Хормозган, а не в Тегеране, как указал сам Claude – это типичная галлюцинация ИИ.
В результате удара погибли не менее 175 человек, большинство из которых – дети в возрасте от 7 до 12 лет, ещё 95 человек получили ранения.
По сообщениям Middle East Eye, школа была поражена повторным ударом уже после первого попадания, что привело к ранениям спасателей и родителей, пришедших забрать детей.
Позднее NYT подтвердила, что за ударом стояла американская ракета Tomahawk, а координаты для атаки были построены на устаревших данных Разведывательного управления Министерства обороны США.
Ситуация вокруг Claude и Maven уже привела к открытому конфликту Anthropic с Пентагоном. 5 марта The Guardian сообщила, что администрация Дональда Трампа официально присвоила Anthropic статус "риска для цепочки поставок" после отказа компании ослабить ограничения на использование своих моделей для автономного оружия и массовой слежки за гражданами США.
Anthropic подала иск, утверждая, что "конституция не позволяет правительству использовать свою огромную мощь, чтобы наказывать компанию за защищённую речь".
Пресс-секретарь Белого дома Лиз Хьюстон ответила жёстко.
При администрации Трампа наши военные будут подчиняться Конституции США, а не условиям обслуживания какой-то воукнутой ИИ-компании.
Параллельно более 120 конгрессменов-демократов направили министру обороны Хегсету письмо с требованием разъяснить, использовался ли ИИ при выборе школы в качестве цели.
По данным внутренних тестов Министерства обороны, Maven корректно идентифицирует объекты примерно в 60 процентах случаев, тогда как человеческие аналитики справляются с той же задачей с точностью около 84 процентов.
Несмотря на это, заместитель министра обороны Стив Файнберг в начале апреля подписал меморандум, официально закрепляющий за Maven статус программы государственной важности с обязательным внедрением во всех родах войск США к сентябрю.




Комментарии