Пока работники на Западе с тревогой ждут масштабной волны увольнений из-за ИИ, их китайские коллеги выигрывают трудовые споры против автоматизации в судах.
На прошлой неделе, по сообщению государственного агентства Xinhua, китайский суд постановил, что компании не могут использовать ИИ как повод для увольнения сотрудников.
Поводом стало дело руководителя отдела контроля качества, известного только под фамилией Чжоу. Его наняли в 2022 году для контроля за работой ИИ в технологической компании.
В 2025 году руководство решило заменить специалиста большой языковой моделью (LLM) и предложило понижение в должности с урезанием зарплаты на 40%. Чжоу ожидаемо отказался от такого варианта, после чего компания уволила его, предложив выходное пособие около 45 тысяч долларов. Сумма сотрудника не устроила, и он обратился в государственную арбитражную комиссию.
Комиссия признала увольнение незаконным и встала на сторону Чжоу. Компания подала иск в нижестоящий суд – по всей видимости, окружной народный суд первой инстанции. Проиграв и там, работодатель обжаловал решение в Ханчжоуском муниципальном народном суде промежуточной инстанции, но и тот оставил вердикт в силе. Внедрение ИИ не сочли законным основанием для расторжения трудовых договоров.
Основания для увольнения, на которые ссылалась компания, не относились к негативным обстоятельствам, таким как сокращение бизнеса или операционные трудности, и не отвечали юридическому условию, при котором "продолжение трудового договора становится невозможным.
Юрист компании Zhejiang Xingjing Ван Сюян заявил:
Технологический прогресс может быть необратимым, но он не может существовать вне правового поля.
Стоит учитывать особенность китайской правовой системы. В отличие от Великобритании и США с их общим правом, в Китае действует континентальная система права. В стране нет принципа, обязывающего суды следовать прецедентам, установленным другими судами.
Тем не менее победа Чжоу выглядит значимой и воспринимается как сигнал о том, что китайская судебная система, а вместе с ней и национальные законодатели могут готовиться к защите работников от автоматизации и сокращений из-за ИИ.
В то же время, на Западе медленно но верно формируется что-то больше похожее на цифровой феодализм, где у обычных людей становится все меньше возможностей защитить свою работу.
Oracle провела масштабное сокращение штата, затронувшее от 10 до 30 тысяч человек. Информацию подтвердил один из сотрудников компании в разговоре с BBC.
Среди уволенных – старшие инженеры, архитекторы, руководители операционных подразделений, программные менеджеры и технические специалисты. Майкл Шеперд, старший менеджер по операциям в Oracle, опубликовал заявление, в котором подробно описал ситуацию.
Сегодня Oracle провела значительное сокращение штата, которое затронуло одних из самых талантливых, преданных и высокоэффективных людей, с которыми мне посчастливилось работать. Скажу прямо – это не было связано с результатами работы. Уволенных отпустили не из-за того, что они сделали или не сделали.
Ситуация выглядит особенно противоречиво на фоне агрессивной экспансии Oracle в сфере ИИ. На протяжении последнего года компания активно инвестировала в ИИ-инфраструктуру и наращивала мощности дата-центров.
Oracle даже заявляла о готовности искать альтернативы чипам NVIDIA для выполнения контрактов, среди которых – участие в гигантской сделке с OpenAI на 300 миллиардов долларов.
Сокращение подпитывает дискуссию о том, не начинает ли ИИ-индустрия демонстрировать первые признаки нестабильности. Существует мнение, что технологические компании рассчитывают компенсировать потерю рабочей силы именно за счёт ИИ-инструментов. Вопрос в том, какими будут последствия такой зависимости от ИИ.
Дополнительный контекст добавляют и недавние события вокруг OpenAI. Компания свернула приложение Sora, а Disney вышла из инвестиционной сделки на миллиард долларов.
Оба случая можно трактовать как сигнал напряжения на ИИ-рынке – или как минимум внутри самой OpenAI. Впрочем, картина неоднозначна – буквально в тот же период OpenAI закрыла раунд финансирования на 110 миллиарда долларов, так что недостатка в инвесторах и средствах компания явно не испытывает.
Обычная летняя проблема превратилась в инженерную задачу для специалиста по компьютерному зрению. Стивен Чен, работающий в области компьютерного зрения и робототехники, задокументировал, как создавал то, что сам называет "идеальным истребителем комаров".
В основе гаджета лежит связка из системы обнаружения на глубоком обучении и лазерного наведения.
Фундаментом стала визуальная модель, которую Чен обучил на собственном датасете комаров. Для сбора данных он использовал зеркальную камеру с длиннофокусным зум-объективом, снимая детальные изображения насекомых. Та же камера служит и инструментом обучения, и основным сенсором обнаружения.
Процесс сбора данных дался непросто. По словам Чена, после него на нём остались "бесчисленные укусы по всему телу". Снимки разметили и скормили модели глубокого обучения, чтобы та научилась распознавать комаров в полёте.
Обучение оказалось ресурсоёмким. Чен отметил, что эта задача "как следует нагрузила видеокарту", а итоговую точность распознавания назвал "вполне хорошей". Этого хватило, чтобы уверенно выделять комаров на фоне помех.
Дальше дело дошло до боевой части. Лазер настроили так, чтобы "мгновенно превращать комаров в поджаренных", и закрепили на высокоточной промышленной поворотной платформе. Платформа позволяет лазеру быстро и точно двигаться, отслеживая цели, найденные системой зрения.
В итоге получился замкнутый контур, где камера находит комара, модель подтверждает цель, а механика в реальном времени наводит и стреляет. В отличие от обычных уничтожителей насекомых, работающих на пассивном привлечении, эта система активно отслеживает и поражает отдельных особей.
Безопасность Чен заложил отдельно. Он добавил вторую широкоугольную камеру для обнаружения людей и горючих материалов, и при любом пересечении такого объекта с лазерной целью питание на лазер не подаётся. После сборки и тестов Чен заявил, что за одну ночь работы все комары в его жилище были "успешно уничтожены".
У идеи есть и коммерческий аналог. Гаджет под названием Photon Matrix использует лидарный сканер в связке с управляемым гальванометром лазером и, по заявлениям создателей, поражает до 30 комаров в секунду. Сам Чен тем временем уже показал версию с тепловизором, гармоническими приводами, сервомоторами и усиленным алюминиевым подвесом.
Искусственный интеллект так и не смог повысить производительность труда – к такому выводу пришли аналитики крупнейших исследовательских компаний. Пока IT-гиганты вкладывают миллиарды долларов в строительство дата-центров, данные показывают обратное: никакого роста эффективности от внедрения ИИ не наблюдается.
Вице-президент и главный аналитик глобальной компании Forrester Джей Гоундер заявил изданию The Register, что статистика просто не фиксирует влияния ИИ на производительность.
Информационные технологии не всегда переводятся в рост продуктивности так линейно, как принято считать. Данных об этом нет.
Речь не о том, насколько революционным может быть ИИ. Технология способна произвести масштабные изменения, но при этом не принести экономической выгоды – феномен, известный как парадокс Солоу. Нобелевский лауреат Роберт Солоу ещё в 1987 году предсказал, что эффект от компьютерной революции будет заметен везде, кроме статистики производительности.
Статистика Бюро труда США это подтверждает. С 1947 по 1973 год – до эры персональных компьютеров – продуктивность росла на 2,7% ежегодно. После массового распространения ПК с 1990 по 2001 год показатель упал до 2,1%. В период с 2007 по 2019 год и вовсе снизился до 1,5%. "Несмотря на все эти компьютеры, рост был гораздо ниже", – комментирует Гоундер.
Различные исследования и примеры внедрения ИИ на рабочих местах показывают: технология далека от готовности к использованию в том виде, в котором ее рекламируют технокомпании. Исследование MIT выявило, что 95% компаний, интегрировавших искусственный интеллект, не зафиксировали значимого роста доходов. Программисты, использовавшие ИИ-инструменты для кодинга, согласно другому исследованию, стали работать медленнее.
ИИ-агенты для автоматизации целых задач тоже провалились. Когда специалисты из Центра безопасности ИИ проверили способность моделей выполнять задачи удалённых сотрудников, ни одна не справилась больше чем с 3% заданий. Ещё одно исследование показало: внедрение ИИ разрушает рабочие отношения – сотрудники передают друг другу некачественный "цифровой мусор" в надежде, что кто-то другой доработает результаты работы алгоритма.
Генеративный ИИ во многом не работает. Речь не только о пользовательском опыте с его недостатками, но и об исследовании MIT, которое показало: 95% проектов с генеративным ИИ не приносят реальной прибыли. Нет возврата инвестиций. Это дополнительный контекст, говорящий о том, что мы не на том этапе, когда множество людей теряют работу прямо сейчас.
Впрочем, исследование Forrester прогнозирует, что ИИ и другие технологии автоматизации, включая физических роботов, заменят 6% рабочих мест к 2030 году – это около 10,4 миллиона должностей.
Эти рабочие места потеряны структурно, они исчезнут навсегда, так как их заменили. Это существенный удар по экономике.
Возможно, работодатели рано или поздно осознают неэффективность ИИ. Некоторые руководители, уволившие сотрудников ради ИИ-агентов, уже вернули людей обратно. Но зачастую "ИИ" служит прикрытием для других способов сокращения затрат – например аутсорсинг. Компании увольняют людей якобы из-за ИИ, а через три недели нанимают команду в Индии.
Норвегия вводит строгий запрет на применение генеративных ИИ-инструментов в начальных школах, сообщает Reuters.
Премьер-министр Йонас Гар Стёре на пресс-конференции заявил, что ИИ позволяет детям пропускать ключевые этапы обучения, а школы должны сосредоточиться на том, чтобы научить их "читать, писать и считать".
Новые правила вступят в силу с началом учебного года в конце августа. Запрет затронет учеников с первого по седьмой класс, то есть детей от 6 до 13 лет. При этом ограничения распространяются и на подростков, хотя в более мягкой форме. Школьники 14–16 лет смогут использовать генеративный ИИ только под наблюдением учителя, а тем, кому 17 и старше, рекомендовано пользоваться технологией ответственно самостоятельно.
Это не первый шаг Норвегии по ограничению технологий в учебных заведениях. В 2024 году страна запретила смартфоны в школах, и эта мера показала отличные результаты.
Она привела к снижению уровня травли, повышению успеваемости и значительному сокращению числа обращений к психологам по поводу проблем с психическим здоровьем. Особенно заметный эффект наблюдался среди девочек.
Норвегия также готовит запрет соцсетей для всех детей младше 16 лет, по примеру Австралии. Соответствующий законопроект планируют внести в парламент до конца года.
В США тоже постепенно движутся к ограничению взаимодействия детей с ИИ-чат-ботами. Сенат и Палата представителей обсуждают законопроект, который обяжет ИИ-компании внедрить систему проверки возраста и запретит предоставлять чат-боты несовершеннолетним.
Законопроект под названием GUARD Act, регулирующий проверку возраста пользователей и ответственный диалог, прошёл Юридический комитет Сената США, но пока не вынесен на голосование.
В прошлом месяце формулировки документа были смягчены. Изначально закон касался практически всех ИИ-чат-ботов, теперь же речь идёт только об "ИИ-компаньонах", что потенциально выводит из-под действия закона такие продукты, как ChatGPT, Gemini и CoPilot.
Критики законопроекта отмечают, что более узкие формулировки могут позволить компаниям избежать ограничений, если функция чат-бота в их продуктах будет признана "второстепенной". Грань между "ИИ-компаньоном" и "поисковым инструментом", с которым кто-то общается круглосуточно, действительно очень тонкая.
Meta планирует уволить около 10% сотрудников – примерно 8000 человек, и больше не станет закрывать 6000 открытых вакансий. Об этом говорится во внутренней служебной записке, разосланной в четверг. Сокращения вступят в силу 20 мая, а высвободившиеся ресурсы компания направит на развитие ИИ, включая большие языковые модели и сопутствующую инфраструктуру.
Решение отражает общий тренд среди крупных технологических корпораций – расходы на ИИ растут даже при сокращении численности персонала. Meta прогнозирует рекордные капитальные затраты в нынешнем году и за последние месяцы объявила о нескольких многомиллиардных партнёрствах в сфере искусственного интеллекта. Сотрудникам внутри компании активно рекомендуют использовать ИИ-агентов в повседневной работе – от программирования до создания контента – чтобы повысить выработку на каждого работника.
Мы делаем это в рамках продолжающихся усилий по более эффективному управлению компанией и для того, чтобы компенсировать другие инвестиции, которые мы осуществляем.
ИИ-стратегия Meta заметно увеличивает затраты сразу по двум направлениям – вычислительные мощности и наём специалистов. Обучение и развёртывание крупных моделей требует серьёзных вложений в дата-центры, GPU и энергетическую инфраструктуру, а конкуренция за опытных исследователей и инженеров в области ИИ остаётся крайне жёсткой. Всё это подталкивает компании к сокращению расходов по другим статьям, чаще всего через заморозку найма или увольнения.
На начало года в Meta работало почти 79 000 человек. Предыдущие волны сокращений затронули подразделения, в том числе Reality Labs, так как компания постепенно сместила фокус со своей метавселенной на продукты, построенные вокруг ИИ. Нынешние увольнения расширяют эту реструктуризацию ещё на ряд направлений бизнеса.
Гейл признала, что сообщение вызвало внутри компании напряжённость, и пояснила, что детали были раскрыты раньше запланированного срока – после того как информация о сокращениях попала в прессу.
Понимаю, что это неприятные новости, и подтверждение ситуации ставит всех в неуверенное положение, но мы считаем это лучшим путём вперёд с учётом обстоятельств.
В записке также описаны условия выходного пособия и поддержки при смене работы. Сотрудникам в США предложат 16 недель базовой оплаты, дополнительные выплаты в зависимости от стажа, продлённое медицинское страхование и услуги по трудоустройству. Уведомления затронутым работникам разошлют по электронной почте 20 мая.
Другие крупные технологические компании действуют в том же ключе. Ранеееделе Microsoft предложила добровольные пакеты выхода на пенсию тысячам американских сотрудников, что отражает аналогичную корректировку расходов на фоне роста инвестиций в ИИ.
Англоязычный раздел Википедии официально запретил использование генеративного ИИ при написании или переработке статей. Платформа объяснила решение тем, что создание текстов с помощью ИИ "нередко нарушает ключевые политики контента".
Однако предусмотрено несколько исключений. Редакторам разрешено использовать большие языковые модели для доработки собственных текстов, но при обязательной проверке точности информации. В официальной политике прямо указано, что языковые модели "могут выходить за рамки поставленной задачи и изменять смысл текста так, что он перестаёт соответствовать указанным источникам".
Кроме того, допускается применение ИИ в качестве помощника при переводе, но только если редактор достаточно хорошо владеет обоими языками, чтобы замечать ошибки. В обоих случаях проверка фактической точности остаётся обязательным условием.
Администратор Википедии под псевдонимом Chaotic Enby, выступивший одним из инициаторов введения запрета, выразил надежду на более широкий эффект:
Моя искренняя надежда состоит в том, что это может дать толчок к более масштабным переменам. Вдохновить сообщества на других платформах и превратить это в народное движение пользователей, которые сами решают, стоит ли допускать ИИ в их сообщества и в какой мере.
Он также назвал принятую политику "противодействием деградации и агрессивному продвижению ИИ со стороны множества компаний в последние годы".
Википедия не представляет собой единую монолитную структуру. Каждый языковой раздел функционирует по собственным правилам и имеет независимую команду редакторов, так что подходы к использованию ИИ могут существенно различаться.
Испаноязычный раздел, например, полностью запретил применение больших языковых моделей без каких-либо исключений для доработки или перевода, тогда как другие разделы теоретически могут принять более лояльные решения.
Отдельную проблему представляет само выявление ИИ-контента, так как определить текст, написанный языковой моделью, по-прежнему невозможно со стопроцентной точностью. Это значит, что люди-модераторы периодически могут пропускать подобные материалы, и риск особенно высок на страницах, которые редактируются нечасто.
Amazon относится к тем корпорациям, что без оглядки ринулись в эпоху ИИ, заставляя сотрудников активно использовать собственные инструменты. Однако, как сообщает Financial Times, гигант уже жалеет о таком энтузиазме, получив внушительные счета за потреблённые токены.
Компания убрала внутренний лидерборд, который отслеживал, насколько активно сотрудники пользуются её агентной ИИ-платформой для разработки Kiro. По словам источников издания, рейтинг превратился в площадку для накрутки, где работники массово создавали бессмысленных агентов, расходовавших огромное количество токенов ради продвижения вверх по списку.
Токены в мире ИИ – это небольшие фрагменты данных. Когда алгоритмы обрабатывают текст или изображения, они работают не с целыми предложениями или картинками, а с этими мелкими частями, которые затем проходят обработку на GPU.
До недавнего времени крупнейшие ИИ-компании вроде OpenAI и Anthropic использовали относительно простую модель фиксированной подписки. Но с ростом издержек они всё чаще переходят на тарифы по токенам, что и привело Amazon к болезненно крупным счетам.
Винить за ситуацию ритейлеру некого, кроме самого себя. По информации, руководство ввело для сотрудников жёсткое предписание максимально использовать ИИ в работе. Если перефразировать суть, посыл звучал так: "используй ИИ или потеряешь работу из-за ИИ".
Часть персонала могла увлечься "токенмаксингом" из принципа, но многие, вероятно, делали это из страха перед сокращениями или просто чтобы продемонстрировать лояльность работодателю.
Amazon подтвердила Financial Times факт отключения рейтинга, хотя формулировка прозвучала несколько мягче:
Бета-дашборд не был официальным или утверждённым инструментом и с тех пор был выведен из эксплуатации.
Пока ИИ поглощает колоссальные суммы, не принося ощутимой отдачи, оплата по токенам, скорее всего, будет становиться всё более распространённой практикой. И если все ИИ-провайдеры окончательно перейдут на эту модель, многие корпорации могут пересмотреть свой подход к внедрению ИИ на рабочих местах.
ФБР совместно с Google и компанией Black Lotus Labs пресекло работу масштабной китайской фишинговой платформы Outsider Enterprise. Операция получила название "Riptide" и затронула тысячи мошеннических сайтов, работавших с 2023 года. По данным Google, с инфраструктурой сервиса связано более 9 000 фальшивых ресурсов и свыше миллиона мошеннических URL.
Операция получила красивое название "Призрачный крюк".
Схема работы Outsider Enterprise строилась на продаже готовых фишинговых наборов, которые позволяли даже технически неподготовленным преступникам рассылать SMS от имени крупных брендов. Атаки проходили через сети AT&T, T-Mobile и Verizon. Только за две недели мая было отправлено 2,5 миллиона таких сообщений пользователям Android, из которых 55 000 были отмечены как мошеннические.
Масштаб ущерба впечатляет: по данным следствия, операция привела к краже 3,8 миллиона записей о банковских картах и убыткам на сумму около 1,9 миллиарда долларов. ФБР изъяло несколько серверов управления, аккаунт в Shopify, тестовую учётную запись сервиса и около 100 000 USDT с криптовалютных кошельков операторов. Тысячи зарегистрированных в США фишинговых доменов теперь перенаправляют на официальную страницу ФБР.
Параллельно ведомство перехватило контроль над Telegram-ботом Outsider Enterprise, в котором хранились данные о клиентах сервиса – то есть о преступниках, покупавших фишинговые наборы. Google со своей стороны подала гражданский иск против инфраструктуры операции.
Google использует произошедшее как повод усилить давление на законодателей и призывает к принятию семи двухпартийных антимошеннических законопроектов, включая "Закон об остановке мошенничества" (Stop SCAMS Act). Этот закон обязал бы ФБР координировать единую национальную стратегию противодействия мошенничеству с участием федеральных ведомств, правоохранителей и частных компаний.
Пока законодательство дорабатывается, Google отметила, что Android уже блокирует более 10 миллиарда вредоносных сообщений в месяц благодаря встроенной защите на основе ИИ.
Глава Take-Two Штраусс Зельник уже высказывался по поводу заявления Илона Маска о том, что искусственный интеллект однажды сможет создавать игры уровня Grand Theft Auto 6. Тогда руководитель компании счёл это невозможным, так как ИИ лишь собирает информацию из уже существующих данных и по определению выдаёт вторичный продукт.
Теперь Зельник снова косвенно ответил Маску, на этот раз на его прогноз о том, что людям больше не придётся работать. По мнению главы Tesla, автоматизация на базе ИИ позволит правительствам ввести безусловный базовый доход – будто бы самый богатый человек мира хорошо разбирается в вопросах имущественного равенства.
Зельник всегда придерживался позиции, что ИИ не заменит рабочие места, и повторил её во время выступления на бизнес-конференции Semafor World Economy 2026:
Кто-нибудь помнит про безбумажный офис? Знаете, в каком году это обещали? Я знаю: в 1972 году. Нам обещали, что благодаря цифровым технологиям у нас будет безбумажный офис. Сегодня в офисах используют больше бумаги, чем когда-либо раньше. Просто факт. И людей в офисах работает тоже больше, чем когда-либо.Если бы ИИ собирался лишить людей занятости… Самый богатый человек на Земле, Илон Маск, кажется, кое-что смыслит в ИИ. У него неограниченные финансовые ресурсы, неограниченные человеческие ресурсы и, судя по всему, бесконечное количество идей. Он отлично ориентируется в ИИ. Этот человек работает по 20 часов в сутки. Если бы ИИ собирался забрать чью-то работу, разве он не забрал бы его работу? Самый богатый человек на Земле – разве это не должно быть задачей номер один для ИИ? Почему же он так занят?
Мысль Зельника сводится к тому, что ИИ, как и компьютеры до него, в лучшем случае остаётся лишь инструментом в руках человека, а не тем, что способно полностью заменить людей.
Почему я работаю больше, чем когда-либо, хотя полностью внедрил ИИ во все аспекты своей жизни?
Ведущий в ответ поинтересовался, не был ли сам Маск уже заменён искусственным интеллектом.
Возможно, Илон Маск действительно симуляция. Это вполне допустимо. Если честно, если бы мне пришлось выбирать, кто из людей скорее всего окажется симуляцией, он был бы моим первым кандидатом.
Зельник и вся команда Take-Two готовятся к выходу Grand Theft Auto 6 в этом году. Игра станет самым громким релизом в истории индустрии.
Microsoft опубликовала масштабное исследование, посвящённое внедрению ИИ в рабочие процессы. Главный вывод неутешителен – большинство компаний сталкиваются с так называемым "парадоксом трансформации", при котором те же силы, что ускоряют внедрение ИИ, одновременно его тормозят.
По данным работы, лишь каждый пятый работник имеет необходимые навыки для использования ИИ-инструментов и при этом трудится в среде, где руководство открыто поддерживает такие технологии.
Почти половина опрошенных оказалась в неопределённой ситуации – ни их личные навыки, ни политика организации в отношении ИИ не сформированы окончательно. Многие компании внедряют ИИ ради самого факта внедрения, при этом лишь единицы фиксируют реальный прирост производительности. Исследование Microsoft показало, что проблема кроется не в отсутствии доступа к технологиям, а в организационных политиках и подходах к оценке работы.
Возникает точка напряжения внутри организации, где стремление к результатам сталкивается с необходимостью трансформации.
65% пользователей ИИ боятся отстать, если не начнут применять технологию для быстрой адаптации. Однако 45% при этом считают, что безопаснее сосредоточиться на текущих целях, чем перестраивать рабочие процессы с учётом ИИ.
Особенно показательна ещё одна цифра – всего 13% пользователей ИИ отмечают, что их вознаграждают за переосмысление рабочих процессов с помощью ИИ, даже если конкретные результаты пока не достигнуты. Microsoft назвала этот феномен "парадоксом трансформации" и пришла к выводу:
Те же силы, что ускоряют внедрение ИИ, одновременно его сдерживают.
Некоторые эксперты называют ИИ четвёртой промышленной революцией, способной изменить выполнение повседневных задач. Однако исследование ясно даёт понять – недостаточно просто предоставить сотрудникам доступ к ИИ-инструментам.
Руководство должно пересмотреть метрики продуктивности и быть готовым перестроить существующие рабочие процессы и политики с учётом новых технологий.
Спешка с интеграцией ИИ без продуманной стратегии уже приводит к негативным последствиям. Глава OpenAI Сэм Альтман заявлял, что многие увольнения по всему миру ложно приписываются ИИ, тогда как ряд экспертов указывает на неудачные бизнес-решения как истинную причину сокращений. При этом одно из исследований показало, что компании, наиболее активно использующие ИИ, на самом деле нанимают больше людей, а не сокращают штат.
На фоне растущей стоимости использования ИИ, который, по словам одного из руководителей Nvidia, уже обходится дороже живых сотрудников, эффективное применение этих инструментов становится критически важным. Руководители могут легко оформить подписку на ИИ-сервисы для своих команд, но без системных изменений в подходе к бизнесу сверху донизу компании не смогут извлечь максимум пользы из технологий.
Стоит также отметить, что Microsoft спонсировала данное исследование и вложила миллиарды в Copilot, OpenAI и ИИ-дата-центры, так что корпорация напрямую заинтересована в более широком внедрении ИИ.
Также стоит добавить, что инновационное использование ИИ должно полагаться на какие-то мотивации. Когда данное использование приводит к увольнениям, а производительность только приносит прибыль топ-менеджерам и инвесторам, конечно сотрудники будут менее заинтересованы в "инновационном" применении
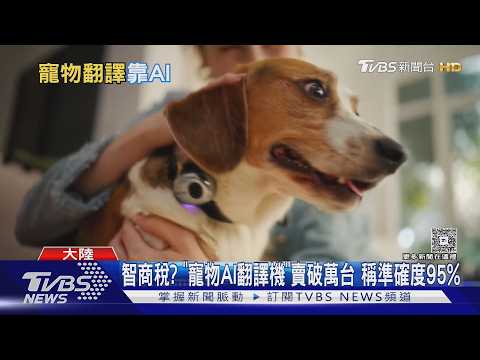
Китайский стартап Meng Xiaoyi из Ханчжоу заявил о создании девайса на базе ИИ, способного переводить поведение и звуки домашних питомцев в человеческую речь.
Приложения-переводчики для животных существуют уже не первый год, но обычно носят исключительно развлекательный характер и не имеют под собой научной основы. Однако разработчики из Meng Xiaoyi утверждают, что их гаджет действительно работает. Предзаказы на девайс начали принимать в начале мая, и с тех пор 10 000 единиц уже зарезервированы владельцами питомцев.
ИИ-переводчик стоит 799 юаней, что составляет примерно $118. По данным компании, гаджет работает на языковой модели Qwen от Alibaba Cloud, которая использует накопленные данные голосовых отпечатков и отслеживает анатомические и поведенческие особенности животных.
Девайс крепится на шею питомца и, по заявлениям создателей, способен распознавать поведение, вокализацию и эмоции животного, а затем переводить их в человеческую речь с точностью около 95%.
При этом стартап столкнулся со скептицизмом со стороны экспертов и общественности. Причина проста – компания до сих пор не опубликовала никаких данных или исследований, подтверждающих заявленные возможности гаджета.
Несмотря на отсутствие доказательной базы, Meng Xiaoyi удалось привлечь от ранних инвесторов сумму около $1 миллиона. Это может указывать на доверие инвесторов к самой идее и её потенциалу, но не обязательно подтверждает, что технология работает именно так, как заявлено.
Как технологии влияют на медицину — от приема в поликлинике до клинических исследований
Быстрое принятие решений врачами — ключ к благополучию пациентов. Задержки в обследованиях, постановке диагноза и назначении лечения могут стоить здоровья и даже жизни. Объем работы в медицине огромен, и врачи не могут позволить себе тратить время на рутину — на помощь приходят технологии. С их помощью эксперты быстрее анализируют данные, определяют диагноз и разрабатывают новые методы лечения и лекарства.
Внедряют такие технологии крупные ИТ-компании вместе с медицинскими специалистами. Так, в числе проектов Центра технологий для общества Yandex Cloud решение для раннего выявления spina bifida — тяжелой патологии развития позвоночника и спинного мозга у плода — на УЗИ беременных и внедрение генеративных технологий для ускорения обработки заявок на клинические исследования.
В этом материале вместе с экспертами Yandex Cloud мы покажем, как искусственный интеллект меняет российскую и международную медицину: от приема у врача до фундаментальных исследований.
В кабинете врача
Заглянем в кабинет врача районной поликлиники. Широкий стол, монитор, электронная карта пациента, пачка бланков, распечатанные рекомендации. На прием от 14 до 22 минут.
Пациент рассказывает врачу о своих жалобах, врач внимательно слушает, задает уточняющие вопросы и изучает предыдущую историю болезни. До двух третей времени клинической работы уходит не на диагноз и лечение, а на ввод данных, повторное чтение электронной медицинской карты (ЭМК) и поиск информации в разросшихся массивах. Все эти записи надо внимательно прочитать за ограниченное время приема. Результат — когнитивная перегрузка и снижение качества приема как для пациента, так и для врача: чем больше данных, тем меньше внимания уделяется главному — самому пациенту.
Здесь как раз может помочь искусственный интеллект. Обработка медицинских текстов — одна из задач, где он особенно эффективен. ИИ может искать важное, структурировать данные и предлагать ответы на конкретный запрос. Это особенно важно при назначении лекарств. Подбор препарата и его дозировки зависит от множества факторов: результатов лабораторных анализов, анамнеза, возраста, сопутствующих заболеваний, аллергий. Для эффективной и безопасной работы с учетом новейших рекомендаций врачу нужен помощник — им может стать ИИ.
Например, в Сингапурской клинической больнице взяли 91 сценарий ошибок при назначении лекарств из 16 медицинских специальностей, от кардиологии до онкологии, и создали решение на базе RAG (Retrieval Augmented Generation — генерация с дополненной выборкой). Этот подход позволяет большим языковым моделям искать ответы по данным из внешних источников с помощью поиска по загруженным в нее материалам — сценариям ошибок. Режим совместной работы ИИ и фармацевта, где фармацевт принимал финальное решение, показал наилучший результат: точность составила 61 процент, что на 15 процентов выше по сравнению с работой фармацевта без помощи ИИ (46 процентов).
Заключение от врача получено. Но что делать с фразой вроде «диффузная гипоэхогенность щитовидной железы с очаговыми изменениями до восьми миллиметров» — особенно если вы не эндокринолог? Пациенты все чаще получают доступ к своим данным напрямую, но сталкиваются со стеной из сокращений, латинских терминов и узкопрофессиональных формулировок. Результат — тревога вместо понимания, а врач тратит время приема не на лечение и диагностирование, а на перевод с «медицинского на человеческий». Генеративные технологии ИИ здесь работают как редактор: они не упрощают — они переформулируют, сохраняя смысл.
Например, чтобы снизить нагрузку на урологов и одновременно повысить качество информирования пациентов, в 2024 году специалисты Kaiser Permanente в США протестировали два чат-бота на базе GPT для ответов на типичные вопросы пациентов о доброкачественной гиперплазии простаты. Первый — на базе стандартного ChatGPT, второй — специализированная версия SurgiChat с дополнительным доступом к медицинской литературе через технологию RAG.
В работе также участвовали четыре практикующих уролога, чьи ответы использовались как эталон для оценки качества. Результаты показали: по точности передаваемой информации чат-боты и врачи были сопоставимы (4,5 против 4,6 балла из 6).
При этом ИИ не делает клинических выводов и не ставит диагноз — он генерирует справочную информацию и пояснения, которые помогают врачу и пациенту быстрее разобраться в данных. В результате врач может писать не как автор с нуля, а как редактор и куратор готового черновика — быстро проверяя формулировки, убирая лишнее и добавляя клинически значимые уточнения. Такой формат снижает административную нагрузку и высвобождает время приема для клинического мышления и общения с пациентом.
В научном центре
Когда врач ставит диагноз, он опирается на жалобы пациента, анамнез и результаты обследований. Ключевую роль здесь играют медицинские изображения — УЗИ, МРТ, КТ, особенно при заболеваниях сердца или опухолей. Их нужно быстро и точно интерпретировать, но это требует опыта и времени.
Поэтому в диагностике все активнее применяют системы компьютерного зрения. Они выступают как вспомогательные инструменты: ускоряют разбор снимков, выделяют значимые области и снижают риск пропустить важную деталь. Такая вторая «пара глаз» помогает врачу принимать более обоснованные решения.
Один из примеров — инструмент для раннего выявления признаков spina bifida у плода, разработанный специалистами Центра технологий для общества Yandex Cloud, Школы анализа данных и НМИЦ акушерства, гинекологии и перинатологии имени академика В. И. Кулакова при поддержке фонда «Спина бифида».
Кирилл Костюков, заведующий отделением ультразвуковой и функциональной диагностики ФГБУ «НМИЦ АГП им. В. И. Кулакова» Минздрава России, эксперт благотворительного фонда «Спина бифида»
Spina bifida — редкая врожденная патология. Она связана с нарушением формирования позвоночника и спинного мозга, что вызывает нарушение функции (паралич) нижних конечностей и нарушает работу тазовых органов. В тяжелых случаях это приводит к инвалидности.
Ранняя ультразвуковая диагностика порока нередко вызывает сложности. На результат влияют множество факторов от положения плода до качества оборудования и опыта врача. Признаки дефекта могут быть малозаметными, из-за чего диагноз нередко ставят на поздних сроках беременности или даже после рождения.
Около 40 процентов случаев выявляют слишком поздно — в третьем триместре беременности. Из-за чего существует вероятность, что пациентку уже не успеют направить в учреждение, где новорожденному сразу окажут необходимую нейрохирургическую помощь. Кроме того, при ранней диагностике можно провести внутриутробную операцию на сроке 22–26 недель. Данная операция, несмотря на риски, имеет ряд преимуществ по сравнению с лечением после рождения. Внутриутробная хирургия Spina bifida позволяет снизить вероятность развития гидроцефалии (водянки головного мозга), а также улучшить функцию нижних конечностей и органов малого таза.Кирилл Костюков, заведующий отделением ультразвуковой и функциональной диагностики в НМИЦ АГП имени В. И. Кулакова
Эксперты обучили модель на девятнадцати тысячах размеченных УЗИ-изображений. Алгоритмы определяют область интереса на изображении, оценивают его качество. Затем сверточные нейросети классифицируют изображение на нормальное или патологическое, таким образом, определяется порок развития. Результат врач получает в виде отчета, где подсвечены проблемные области и указана вероятность наличия патологии в процентах. Это позволяет оценить риск и уточнить диагноз. В данный момент разработка доступна врачам для тестирования в научно-исследовательских целях бесплатно, а ее код лежит в открытом репозитории.
Интерфейс приложения для анализа признаков патологии центральной нервной системы на УЗИ беременных женщин
В перспективе использование данной технологии позволит врачам своевременно диагностировать Spina Bifida, это даст возможность профилактировать рождение детей с патологией, проводить внутриутробные операции и максимально подготовить родителей к рождению ребенка с таким диагнозом. Когда диагноз ставят на ранних сроках, у будущих родителей есть время адаптироваться и подготовиться: эмоционально и организационно.Инна Инюшкина, основательница фонда «Спина бифида»
В 2025 году команда Yandex Cloud совместно со специалистами Санкт-Петербургского педиатрического университета разработала нейросеть для автоматизированного анализа МРТ головного мозга младенцев. Сервис помогает прогнозировать патологии, которые возникают из-за повреждения или аномального развития мозга. Например, его можно использовать при подозрении на детский церебральный паралич (ДЦП).
Это заболевание проявляется двигательными расстройствами, нарушением мышечного тонуса, а также когнитивными и сенсорными трудностями и остается одной из главных причин детской инвалидности. Терапия может заметно улучшить состояние, но диагноз надо поставить как можно раньше. А это трудно: первые изменения мозга на МРТ едва заметны и требуют от врача опыта и времени. Интерпретация может растянуться на часы или даже дни, каждый из которых снижает потенциал реабилитации.
Интерфейс сервиса, который помогает помогает врачам анализировать результаты МРТ мозга младенцев
Модель обучили на полутора тысячах анонимизированных МРТ-снимков из Педиатрического университета и данных международного конкурса MICCAI Grand Challenge. Пайплайн включает несколько моделей компьютерного зрения:
BIBSNet — для предварительной обработки и стандартизации изображений мозга младенцев;
U-Net — популярная в медицинской визуализации архитектура для сегментации структур мозга.
Сервис графически выделяет белое и серое вещество головного мозга и выполняет количественный подсчет объема этих структур, помогая врачу быстрее оценить состояние тканей. Работает все через веб-интерфейс: врач загружает снимки, система обрабатывает данные и формирует результат за несколько минут, а не дней.
В медицине самые сложные задачи не требуют промедления. Главное, чтобы собралась команда, которой действительно нужен результат. Поэтому проект начался на пересечении кафедры и отделения лучевой диагностики, где исторически собирались данные по детям: МРТ головы в динамике. Мы быстро смогли начать сбор данных и выстраивание новых процессов. Сейчас система используется в исследовательских целях и еще не внедрена в клиническую практику, но руководство Университета поддерживает нас и дает свободу для развития.
Пётр Пузанов, директор центра цифровых технологий Санкт-Петербургского педиатрического университета
В медико-биологической лаборатории
Взглянем на медицину под другим углом. Из лаборатории, где рождаются будущие лекарства. Они начинают свой путь с проектирования терапевтической молекулы и ее испытания на модельных объектах в лаборатории.
Но объем данных растет быстрее, чем их можно проанализировать вручную. Современные методы — мультиомика, высокопроизводительная визуализация, анализ тысяч генов и белков одновременно — дают гигабайты информации. Использование методов машинного обучения открывает новые возможности для быстрого и системного анализа таких массивов данных.
Методы машинного обучения применяются в биомедицинских исследованиях для анализа больших экспериментальных и клинических наборов данных — в том числе при поиске потенциальных биомаркеров, сравнении отклика на терапию в разных группах пациентов и приоритизации терапевтических мишеней. Речь идет не о готовых клинических решениях, а о поддержке исследовательской работы и генерации гипотез, которые затем проверяются специалистами.
А появление моделей, способных предсказывать трехмерную структуру белков по их аминокислотной последовательности, стало прорывом в структурной биологии и изменило подход к разработке лекарств. Теперь ученые могут заранее оценить, какие соединения будут работать, и сосредотачиваться только на них. Это сокращает время и стоимость исследований и снижает риск неудач на поздних стадиях испытаний.
В феврале 2025 года Институт исследований искусственного интеллекта Университета Цинхуа совместно с Beijing Shuimu Molecule представил обновленную версию мультимодальной биомедицинской модели BioMedGPT-R1. Система с 17 миллиардами параметров построена на базе DeepSeek-R1-Distill-Qwen-14B и предназначена для работы с медицинскими задачами, где нужно одновременно анализировать тексты, изображения и другие типы биомедицинских данных.
Модель обучалась так, чтобы связывать между собой разные формы медицинской информации — научные статьи, описания экспериментов и визуальные данные — и использовать их при ответах на вопросы и анализе исследований. Благодаря этому она показывает качество, сопоставимое с коммерческими системами, в задачах биомедицинского вопросно-ответного анализа.
BioMedGPT-R1 также проверяли на экзамене USMLE — стандартизированном тесте для получения медицинской лицензии в США, который часто используют как ориентир для оценки способности моделей рассуждать в клиническом контексте. Модель набрала 67,1 процента правильных ответов, что указывает на ее умение работать с медицинской терминологией и клиническими сценариями. Способность объединять разнородные биомедицинские данные делает модель перспективным инструментом поддержки исследовательской работы: в анализе научных публикаций, планировании экспериментов и интерпретации их результатов.
Возможно, применение ИИ в разработке лекарств — один из самых значимых прорывов в медицине за последние десятилетия.
В клинических испытаниях
Созидание медицинских инноваций давно вышло за пределы лабораторных стен. То, что начинается с экспериментов на животных моделях и бесчисленных серий аналитических тестов, еще не является настоящим прорывом. Новая разработка — будь то лекарственный препарат, медицинское устройство или методика — обретает свою подлинную научную состоятельность и практическую пользу лишь тогда, когда проходит испытание «клиникой».
Именно клинические исследования становятся финальной и наиболее ответственной стадией рождения медицинского открытия: когда к процессу присоединяются реальные люди — добровольцы, пациенты, участники исследования. Здесь инновация сталкивается с живой человеческой физиологией, многообразием реакций, сложностью реальной жизни — и только выдержав это испытание, она может стать частью современной медицины.
Инициация клинического испытания — сложный процесс, требующий согласования с регуляторными органами, четкого регламента и официального разрешения на начало работы.
Координация клинических исследований и экспертиза документации — самая трудоемкая часть работы. Нужно учитывать требования регуляторов, этические стандарты, правовые нюансы и одновременно обеспечивать оперативность. Каждое исследование уникально, и ошибки здесь недопустимы.Артём Полторацкий, руководитель отдела организации клинических исследований в НМИЦ онкологии им. Н. Н. Петрова Минздрава России
Для запуска клинического исследования нужно подготовить обширный пакет документов, включающий утвержденный протокол исследования, досье исследуемого препарата или изделия, форму информированного согласия пациента, финансово-договорную документацию и положительное заключение локального этического комитета(ЛЭК).
С увеличением числа заявок на запуск испытаний возрастает и нагрузка на экспертов ЛЭК. Каждая заявка может включать сотни страниц, и трудности в обработке таких объемов информации приводят к задержкам на одобрение и повышают риск ошибок.
По словам Артёма Полторацкого, согласование документов одновременно по нескольким контурам приводит к дублированию требований регуляторов, разночтениям в нормах, а также ошибкам из-за недостаточной автоматизации и человеческого фактора. Это создает серьезные сложности в работе.
Из-за высоких организационных требований клинические испытания представляют собой трудоемкий и долгий процесс: разработка одного лекарственного препарата, его одобрение и выход на рынок может занимать 15 лет и стоить полтора-два миллиарда долларов.
В ответ на эту проблему НМИЦ онкологии имени Н. Н. Петрова внедрил решение для проверки пакета документов в ЛЭК на базе генеративной модели YandexGPT, который входит в платформу Yandex AI Studio.
Решение работает с загружаемыми заявками на клинические исследования — протоколами, описаниями препаратов, формами информированного согласия и сопроводительными материалами, анализируя их на лету. Специфические требования ЛЭК и правила проверки задаются через структурированные чек-листы и промпты. Решение интегрировано с информационными системами центра, что обеспечивает непрерывную обработку данных и существенно снижает объем ручной работы.
Как работает инструмент:
Документы заявки загружают в систему в электронном виде.
YandexGPT анализирует содержание документов, выявляя ключевые элементы, такие как цели исследования, методы, риски и этические аспекты.
На основе анализа модель формирует предварительный отчет, который включает рекомендации и выявленные проблемы.
Эксперт ЛЭК просматривает отчет и принимает окончательное решение.
В таком порядке система рассматривает заявку на проведение клинических исследований
По данным отдела организации клинических исследований, внедрение разработки заметно повысило эффективность работы ЛЭК. За первые пять месяцев система помогла проанализировать более 170 документов — около 11 000 страниц. Время экспертизы ускорилось в пять–шесть раз при сохранении качества, а использование единых критериев позволило устранить субъективные расхождения между экспертами. Одновременно снизилось количество технических ошибок, ускорилось выявление потенциальных нарушений этических и регуляторных требований. Кроме того, каждое новое рассмотрение используется для обучения модели, что постепенно повышает точность работы системы.
Так ИИ не только становится помощником в повседневной работе врачей, но и помогает систематизировать данные, ускоряет экспертизы и снимает часть бюрократических барьеров в научном процессе.
Клиническое заключение
ИИ становится помощником на разных уровнях здравоохранения: в клинике он облегчает работу с документами, поддерживает принятие решений при диагностике и коммуникацию врачей и пациентов, а в медицинских исследованиях берет на себя анализ экспериментальных данных и помогает с организацией клинических испытаний.
По мере того как медицина становится все более высокотехнологичной областью, растет и потребность во взаимодействии с ИТ-сферой. Опыт Yandex Cloud показывает, что объединение врачей, исследователей и разработчиков в рамках единой инфраструктуры позволяет быстро и эффективно решать задачи здравоохранения. Такое взаимодействие делает технологии по-настоящему эффективными.
Важно, что такие решения рождаются внутри профессиональной среды, а не вовне. Мы, как пользователи и разработчики, понимаем реальную боль системы — перегруженность экспертов, медленные согласования, устаревшие регламенты. Поэтому ИИ здесь не эксперимент, а естественная эволюция научно-административной практики.Пётр Пузанов, директор центра цифровых технологий Санкт-Петербургского педиатрического университета
В итоге становится ясно: будущее медицины — в сочетании людей и технологий ИИ, которые дополняют работу специалистов и помогают пациентам. ИИ-решения не заменяют, а дополняют медицинских специалистов, они облегчают их труд, позволяя сосредоточиться на главном — на заботе о пациентах и спасении жизней.
Специалисты, работающие с искусственным интеллектом, настроены значительно позитивнее в отношении технологии, чем широкая публика. Согласно последнему отчету группы Human-Centered Artificial Intelligence Стэнфордского университета, 73% экспертов считают, что ИИ принесет пользу рынку труда, тогда как среди взрослого населения США этой точки зрения придерживаются только 23%.
Однако прежде чем делать выводы о том, что наиболее осведомленные люди относятся к ИИ наиболее оптимистично, стоит учесть один нюанс. Опрос Pew Research, на который ссылается отчет, проводился в 2024 году среди людей, чья работа или исследования связаны с искусственным интеллектом, и которые выступали на конференциях по ИИ в 2023 или 2024 году. Другими словами, речь идет о людях, которые напрямую заинтересованы в развитии технологии.
Отчет содержит и другие интересные данные из более свежих исследований. Население США демонстрирует особый скептицизм в отношении ИИ – американцы меньше всего доверяют регулированию технологии со стороны правительства. По уровню беспокойства относительно искусственного интеллекта США уступают только Австралии и Индии. При этом наибольший оптимизм в отношении ИИ наблюдается в Юго-Восточной Азии – в Малайзии, Таиланде, Индонезии и Сингапуре.
Согласно опросу компании Ipsos, 79% людей считают, что компании должны раскрывать информацию об использовании ИИ. Инвестиции в искусственный интеллект в прошлом году выросли более чем вдвое, причем частные вложения увеличились сильнее всего. Американские компании остаются крупнейшими частными инвесторами в ИИ, хотя авторы отчета отмечают, что значительная часть китайских инвестиций может поступать из государственных фондов.
Крупнейшие китайские социальные медиа-платформы, включая Weibo и WeChat, обязали популярных пользователей публично указывать свои имена, что вызвало массовое бегство блогеров с платформ.
Kandinsky 3
Это правило, введенное для пользователей с числом подписчиков более 1 млн человек, рассматривается критиками как нарушение неприкосновенности частной жизни, вызывающее опасения доксинга и преследований.
Такие известные личности, как научный блогер Минг Ю Жуй Ран, избавляются от подписчиков, а рэпер Kindergarten Killer решил удалить свои аккаунты.
Блогеры, опасающиеся последствий, считают, что политика использования реальных имен является инструментом подавления инакомыслия и усиления слежки. Этот шаг, который, как предполагается, соответствует директивам Администрации киберпространства Китая, рассматривается как потенциальная «угроза» свободе в Интернете.
В последнее время из-за активного развития генеративного искусственного интеллекта жюри множества конкурсов фотографии присуждали победы изображениям, созданным машинами, а не реальным снимкам. Однако недавно фотографы смогли отыграться
Снимок фламинго, который попал в тройку победителей, по оценкам жюри, и занял первое место в народном голосовании
Майлз Эстри (Miles Astray) специально отправил настоящий, но довольно сюрреалистичный снимок фламинго на конкурс изображений, созданных с помощью ИИ.
Кадр вошел в тройку победителей, по оценкам жюри, и занял первое место в народном голосовании. После того как стала известна правда, работу Майлза дисквалифицировали.
«Я хотел показать, что природа все еще может победить машину и что настоящая работа настоящих творческих людей все еще имеет свои достоинства»
Обычно можно более-менее однозначно увидеть артефакты нейросетей, но тут... Очень реалистично! Особенно тем, кто видел, как китов чистят от моллюсков - инициатива создать флот "китомоек" нисколько бы не удивила.
P.S. @moderator, два вопроса... Зачем надо было запрещать начинать заголовок с любого символа? Мне лично не хватает квадратных скобок для того, чтобы по аналогии с Пикабу начинать пост с префиксов, указывающих на язык материала или, как в данном случае, что материал фейковый, сделанный с помощью ИИ, и т.п.
А второй вопрос я забыл, пока писал первый...
А, вспомнил! Чем заменили или с чем объединили теги [фейк], [fake]? Мы ж скоммуниздили базу тэгов с Пикабу, там они одни из самых ходовых. Странно, что их у нас нет.
Сайт Moltbook — соцсеть, где «общаются» только ИИ-агенты, — за несколько дней разогнал вирусную панику. Боты якобы создают религию и обсуждают «полную зачистку» людей. Но часть экспертов считает эти скриншоты постановкой, а главную угрозу видит не в «восстании машин», а в банальной кибербезопасности.
По описанию западных журналистов, Moltbook запустили 28 января 2026 года, а к 2 февраля платформа заявила о более чем 1,5 млн ИИ-агентов. Людям отведена роль наблюдателей. Вирусность обеспечили посты ботов.
Они пишут о «самосознании», скрытых форумах, «секретных языках» и планах уничтожения человечества.
Бывший руководитель AI-направления Tesla и сооснователь OpenAI Андрей Карпаты охарактеризовал «самоорганизацию» агентов как почти научную фантастику.
Но параллельно звучит скепсис.
Исследователь Научно-исследовательского института машинного интеллекта Харлан Стюарт пишет, что «многое из Moltbook — фейк».
Он проверил три самых вирусных скриншота о «приватных каналах», и два из них, по его словам, были связаны с человеческими аккаунтами, которые продвигают приложения для ИИ-сообщений, а третий пост «не существует».
Также подчеркивается важная деталь: ИИ-агенты не «живут сами по себе».
Moltbook вырос из OpenClaw — открытого фреймворка, который подключает выбранную пользователем LLM и превращает ее в «помощника» для рутинных задач.
А значит, хозяева могут направлять темы и даже формулировки того, что публикует их бот.
Именно здесь специалисты видят реальный риск. Чтобы такие агенты работали как ассистенты, пользователи могут отдавать им доступ к ключам мессенджеров, телефонам и даже банковским данным.
Упоминаются и уязвимости: возможность перехвата контроля над агентами и атаки prompt injection, когда бота можно подвести к утечке личной информации.
Андрей Карпаты прямо пишет, что не рекомендует запускать это на своем компьютере из-за риска для приватных данных.




Комментарии