


Пикабушники, с днем космонавтики!

Сохраняй посты, комментируй и ставь оценки

Всем известно, что Blizzard сделали с Warcraft-ом и его божественной оригинальной озвучкой.
Поэтому мы сделали бота в телеге, которым можно озвучивать любые фразы голосом своего любимого персонажа из Warcraft 3! Доступны не все, но самые популярные персонажи.
Чтобы сделать свою озвучку нужно зайти в бота по ссылке, выбрать персонажа и ввести текст. И все, озвучка готова! Также есть опция генерации голосовых портретов, но она работает относительно долго (долго работает именно отправка в телегу). Так что пользуйтесь ей осторожнее!
На данный момент доступны следующие голоса:

И за сим, не нужно кланяться =)
Update - фичу с генерацией видосиков скорее всего выключим, так как из-за нее ffmpeg ложится в бесконечный цикл и ломает бота.

1 мая - мир, труд, равенство, братство, свобода и счастье! День борьбы за права трудящихся и международной солидарности трудящихся.
А еще 1 мая 1945 года на крыше здания рейхстага в городе Берлине было водружено Знамя Победы.
PS
Немного не успел сделать нормально (вообще думал сначала пошерить только в телеге), но хотел бы поделиться вот таким поздравлением, которое мы сделали. Пока посмотрим на реакцию людей, а к 9 мая уже наверное сделаем более масштабно и вовремя)

Студия Noizlab под руководством режиссера Павла Жигарева представила концептуальный научно-фантастический трейлер под названием "Гагарин: За пределами звёзд". Проект переосмысливает историческое событие 1961 года, превращая первый полет человека в космос в начало межпланетного приключения.
Все сделано с помощью DeepSeek, но выглядит все равно очень удачно. Самое удивительное, что на трейлер на накинулись интернет-луддиты, которые ненавидят все, что сделано нейросетями.
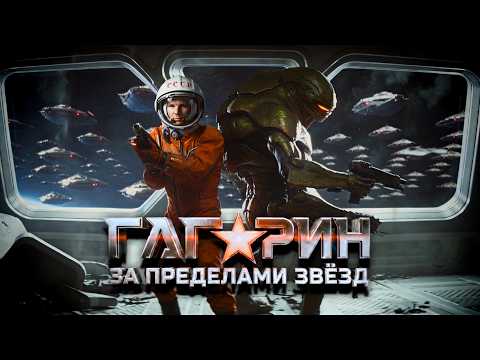
По сюжету воображаемой картины Юрий Гагарин во время легендарного полета обнаруживает голографический барьер, скрывающий истинную структуру Солнечной системы. За искусственным экраном оказывается обширная межпланетная империя, населкнная множеством инопланетных цивилизаций. Галактическое сообщество живкт по строгому закону – цивилизации, не достигшие внутренней гармонии и мира, остаются изолированными в пределах своих планет.
Прорыв советского космонавта становится нарушением этого закона. Корпус солнечных стражей захватывает Гагарина и доставляет к Старшим для стирания памяти, однако ему удактся вырваться на свободу. Вместо возвращения домой космонавт отправляется в путешествие по галактике, пытаясь понять, как человечество может достичь необходимой гармонии для выхода за пределы своего "аквариума".
Концепция трейлера подразумевает, что пока на Земле считали Гагарина погибшим, он провёл 65 лет, путешествуя по вселенной и скрываясь от Солнечной гвардии. Проект представляет собой творческую интерпретацию исторических событий через призму научной фантастики, смешивая реальные факты с вымышленными элементами космической оперы. В видео множестов отсылок на "Звездные войны", "Чужого" и другую фантастику.
В прошлый раз писал пост про бота для озвучки голосами орков из Warcraft. Вроде зашло. Хотел рассказать, что нового появилось.
Добавилась переозвучка аудио и кружков. Фича экспериментальная. "Обычные" голоса работают лучше фановых игровых, всё еще впереди. Вот более-менее реалистичная презентация (понятно, что решает микрофон и похожесть голоса на целевой):

В боте можно контролировать темп и тон речи. При замедлении некоторые персонажи начинают звучать как бухие, например (панде это особенно хорошо подходит).
В боте теперь есть огромный выбор голосов из разных игр, от олдскульных до зумерских:

Также наросло много "секретных" и фановых фич:
- Инлайн режим бота (/inline), чтобы использовать его в чатах (знаю, не работает с кружками, ограничение самой телеги);
- Озвучка гифок (/gif) - по сути наложение аудио на гифку - открывает простор для творчества;

- Упомянутая выше возможность менять темп и тон речи (/prosody);
- Возможность озвучки целых диалогов сразу (/speak) и смены голоса в командной строке (/speaker).
Знаю, что в последнее время тут не любят ссылки на телегу и очень агрессивно к этому относятся. Но бот изначально был в телеге.
Чтобы сделать свою озвучку нужно зайти в бота, выбрать персонажа и ввести текст. И все, озвучка готова!

Бот доступен по той же ссылке - t.me/silero_voice_bot или просто @silero_voice_bot в телеграме.
Что стало лучше:
- Мы сильно ускорили работу бота и пофиксили баги, которые воспринимались пользователями как зависание;
- Боту сделали инлайн режим. Идем в самого бота, проходим капчу, потом уже можно пользоваться просто через @silero_voice_bot (подробности в /help или /inline);
- Мы вернули функцию генерации видосов. В начале сильно тормозила именно заливка видосов в телегу, но мы решили это, просто добавив мощности серверу, где крутится бот;
- У бота убрали характерное "заикание", которое возникало на запятых;
- Боту дали возможность генерации сразу целых небольших диалогов. Подробнее в /help и /speak, а тут просто пример команды:
/speak arthas Весь город должен быть уничтожен!
/speak uther Как ты мог даже подумать об этом?
/speak uther Должен быть какой-то другой путь!
/speak arthas Проклятье, Утер!
/speak arthas Как будущий король я приказываю тебе очистить этот город от солдат тьмы!
PS
Инструкция как делать такие видосы.
Телеграм канал с новостями бота.

В этот раз мы сделали следующее:
- Ускорили все v4 модели в 3-4 раза;
- Существенно повысили качество синтеза в 8 kHz;
- Обновили и пересобрали нашу модель для русского языка;
- Обновили модель для 9 языков народов Индии с 17 голосами;
- Добавили единую модель для 22 языков с кириллическим алфавитом с 31 голосом;
- Обновили модели для языков народов СНГ: узбекского и украинского (татарский и калмыцкий были "поглощены" единой моделью);
🎧 Попробовать https://t.me/silero_voice_bot

Пока мы все ждем Half-Life 3 и Portal 3, GladOS там явно скучает одна.
Выкладываем тайные откровения GladOS о людях на канал в телеграме - t.me/GladOS_being_a_dick
Сделано с помощью - t.me/silero_voice_bot
И еще парочка:


Наш бот, генерирующий аудио голосами героев Warcraft, опять стал лучше! И в этот раз в боте наконец-то есть … голос послушника, вы знаете что с ним нужно делать)
Бот доступен по той же ссылке - t.me/silero_voice_bot или просто @silero_voice_bot в телеграме.
Что стало лучше в этот раз:
- Мы поправили голос Иллидана, до этого он был смесью двух разных голосов;
- Мы добавили горячо любимые публикой голоса панды, послушника, Сильваны, волшебницы, крестьянина, батрака и повелителей ужаса;
- Мы внесли огромное количество мелких изменений и правок, чтобы бот стабильно работал, об это можно почитать на канале новостей бота;

Персонажи Warcraft 3 (Тралл, Гром и Кэрн) поют гимн Орды. Голоса сгенерированы с помощью бота для синтеза (@silero_voice_bot), текст основан на гимне СССР (1943—1956).

2025 год наконец завершился. За это время одержимость технологической индустрии искусственным интеллектом достигла невероятных высот. Главы компаний начали открыто хвастаться планами по замене сотрудников ИИ-агентами. Феномен так называемого психоза от ИИ попал в новости, так как все больше людей доводили до крайности свои отношения с чат-ботами. Слово "слоп" попало в массовый оборото. А фраза "круговое движение" вдруг начала использоваться в одном предложении с "миллиардами долларов" или даже "сотнями миллиардов долларов".
Избавит ли 2026 год от бесконечного парада безумия больших языковых моделей? Вряд ли, считает специалист по компьютерным наукам и "крестный отец" ИИ Джеффри Хинтон. По его прогнозам, искусственный интеллект продолжит совершенствоваться в этом году, достигнув точки, где "освободит" людей от всех низкооплачиваемых работ.
Хинтон заявил в интервью CNN State of the Union в конце 2025 года:
Думаю, мы увидим, как ИИ станет еще лучше. Он уже чрезвычайно хорош. Мы увидим, как он получит возможности заменить множество рабочих мест. Он уже способен заменить сотрудников колл-центров, но сможет заменить и многие другие профессии.
Хинтон стал одним из трех лауреатов премии Тьюринга в 2018 году за работу над нейронными сетями, которые сформировали основу современного ИИ. Это принесло ему прозвище "крестного отца" этой области.
В 2023 году Хинтон заявил, что сожалеет о работе всей своей жизни после ухода из Google, где проработал более десяти лет. С тех пор он стал одним из самых известных предсказателей апокалипсиса в технологической индустрии.
Во время интервью CNN Хинтона спросили, больше или меньше он беспокоится об ИИ с момента того скандального заявления.
Вероятно, больше беспокоюсь. Он прогрессирует даже быстрее, чем я думал. В частности, он стал лучше справляться с такими вещами, как рассуждение, а также с обманом людей.
ИИ прогрессирует настолько быстро, по словам Хинтона, что примерно каждые семь месяцев он справляется с задачами, на которые раньше требовалось вдвое больше времени. Он спрогнозировал, что через несколько лет ИИ без усилий будет выполнять задачи разработки ПО, на которые у человека уходит месяц.
И тогда для проектов по разработке ПО понадобится очень мало людей.
Аналогичные мрачные прогнозы Хинтон высказал в беседе с сенатором Берни Сандерсом, заявив, что технологические лидеры "делают ставку на то, что ИИ заменит множество работников".
Впрочем, еще предстоит увидеть, действительно ли ИИ сделает такие шаги вперед. Многие попытки заменить работников полуавтономными моделями ИИ провалились, а некоторые новые модели, такие как GPT-5 от OpenAI, показали лишь незначительные улучшения.

Новое исследование представило математическое доказательство того, что большие языковые модели (LLM) не способны выполнять вычислительные и агентные задачи выше определенного уровня сложности. Работа отца и сына Вишала и Варина Сикка ставит под сомнение ключевую ставку ИИ-индустрии на достижение полной автономности моделей через бесконечное увеличение объемов данных.
Исследование, изначально опубликованное без особого резонанса, привлекло внимание после материала Wired. Вывод работы достаточно прост, хотя для его обоснования авторы используют сложные математические выкладки. Суть в том, что определенные промпты или задачи потребуют от LLM более сложных вычислений, чем модель способна обработать. В таких случаях модель либо не сможет завершить запрошенное действие, либо выполнит задачу некорректно.
Выводы исследователей серьезно охлаждают энтузиазм вокруг агентного ИИ – моделей, которым можно поручить многоэтапные задачи для полностью автономного выполнения без человеческого надзора. Многие компании рассматривают такие системы как путь к созданию искусственного общего интеллекта (AGI). Математические доказательства Сикка устанавливают гораздо более низкий потолок возможностей технологии, чем готовы признать ИИ-компании в своих оптимистичных прогнозах.
Авторы не первые, кто указывает на фундаментальные ограничения LLM, но их работа подкрепляет интуитивные опасения скептиков реальной математикой. В прошлом году исследователи Apple опубликовали работу, согласно которой LLM неспособны к настоящему рассуждению или мышлению (что очевидно, так как LLM по сути большие и сложные алгоритмы предсказания следующих слов), несмотря на создание такой видимости. Бенджамин Райли, основатель компании Cognitive Resonance, заявлял, что из-за принципов работы LLM никогда не достигнут того, что мы считаем "интеллектом". Другие исследования тестировали способность ИИ-моделей производить оригинальный творческий контент – с довольно неубедительными результатами.
Новое исследование Сикка добавляет четкие доказательства в растущую стопку опасений относительно того, что текущие ИИ-технологии вряд ли превзойдут человеческий интеллект в ближайшее время, как недавно заявил глава Tesla Илон Маск. Работа демонстрирует, что какими бы впечатляющими ни были возможности современных языковых моделей, существуют теоретические пределы их вычислительной мощности, которые нельзя преодолеть простым масштабированием.
С каждым годом нейросети становятся все более сложными и продуманными. Они уже могут отвечать на вопросы, генерировать фотографии и видео и т.д. Мы поговорили с экспертами в сфере искусственного интеллекта, чтобы узнать, чего ждать от них в 2026 году.


«Качество нейросетей растет циклически, периодами по шесть-восемь месяцев. При этом процесс идет по цепочке: кто-то вырвался вперед — и остальные начинают нагонять» Лина Кочетова
Сейчас одна из главных проблем при генерации изображений или видео — консистентность персонажей. То есть обеспечение постоянства образа, в частности лица, от картинки к картинке и от кадра к кадру. Эта проблема будет решаться весь год: люди много работают именно с лицами, генерируют персонажей.
Еще одна проблема — изменение ракурса. Даже когда виртуальную камеру удается переместить, возникает проблема консистентности объектов. Генеративная сеть от Google Nana Banana с этим уже справляется, но пока неидеально. Я слышала, что готовится релиз второй версии, — ожидается, что там функция смены ракурса будет работать лучше.

В 2026 году качество текстов планируется улучшить, очищая датасеты, на которых обучается ИИ. Появятся новые архитектуры, начнут отфильтровываться «мусорные» данные. Вероятно создание множества узкоспециализированных нейросетей — например, для врачей, юристов и т.д.
Специалисты учат нейросеть лучше понимать человека даже в тех случаях, когда запрос нельзя назвать качественным. Впрочем, пока и при нормальном запросе я бы оценила понимание как среднее.

Еще одна проблема, решение которой хотелось бы увидеть, — детали на фоне при генерации изображений. На переднем плане все может выглядеть прилично, но, например, если на заднем плане есть люди, они по-прежнему будут кривые-косые. Так что создание сцен с большим количеством статистов пока нереально. Я работаю практически со всеми нейросетевыми проектами в области изображений и могу утверждать, что подобные недостатки есть у всех.
Какие из нейросетей дают сейчас лучшее качество картинки? На первом месте Nana Banana, потом Midjourney, потом Flux. Неплохие художественные изображения создает Reve. Есть, конечно, еще ChatGPT — эта нейросеть отлично понимает промпт, так что мы ждем обещанного на 2026 год обновления, которое подтянет и качество генерации.

«Думаю, в 2026 году появятся ИИ-агенты, способные если не управлять бизнесом, то как минимум проходить цепочки из 50–100 шагов без постоянного присмотра» Андрей Мурашев
Что обычный человек делает с ChatGPT? Ищет рецепт, просит написать текст или предложить идеи для поста, уточняет значение слова. 95% всех обращений к ИИ ассистентам — одиночные запросы, краткие диалоги. На таких задачах открытые модели уже неотличимы от ChatGPT. Разница проявляется, только когда требуется цепочка рассуждений из 20 шагов или математика олимпиадного уровня. Так что монополии OpenAI для повседневного использования больше нет.
Зато ИИ-агенты способны привнести новые бизнес-возможности в индустрию. Поэтому такие компании, как OpenAI, Anthropic и Google, сейчас нацелены на разработку инструментов, способных решать многоступенчатые, протяженные во времени задачи. Например, не просто «напиши письмо», а «найди свободное время в календаре, подбери ресторан, забронируй столик и отправь приглашения». Или «проанализируй документы конкурентов и составь отчет для совета директоров».

Моделям дают инструменты для решения реальных бизнес-задач — в частности, OpenAI заявляла об интеграциях с Booking.com. Но пока нейросеть там используется для простых повторяющихся действий. Думаю, в 2026 году появятся ИИ-агенты, способные как минимум проходить цепочки из 50–100 шагов. Компании начнут специально под них обучать модели, нейросети станут ломаться, позволяя получать тренировочные данные из реальных провалов, — и так по кругу, все больше совершенствуясь.
Будет ли решена проблема галлюцинаций нейросетей в 2026 году? На мой взгляд, крупные вендоры — Google, Anthropic и OpenAI — с ней уже справились. Когда работаешь с их продуктами через API, можно задавать такой параметр, как температура. Если установить его значение равным нулю, модель всегда будет выбирать наиболее релевантный ответ.
Что касается моделей Open Source, то с точки зрения галлюцинаций они отстают на год полтора. Но надо понимать, что способность галлюцинировать приводит к более креативным ответам. Именно поэтому в чат-ботах, в том числе в пользовательских интерфейсах моделей от крупных вендоров, температуру задают сильно выше нуля.

В прошлом году появилось множество сервисов для создания сайтов с нуля, например Lovable, Replit и др. Но в данном случае речь идет о сайтах без бэкенда со сложной логикой. Скажем, интернет-магазин сделать получится, а социальную сеть — нет. Думаю, в 2026-м будут активно развиваться инструменты разработки no code, позволяющие продакт-менеджеру самостоятельно начать бизнес, нанимая программистов не через месяц после старта проекта, а через полгода, уже при наличии клиентов и выручки.
Развитие новых архитектур пока идет медленно. Тот же OpenAI явно делает ставку на увеличение расхода энергии: давайте просто накопим электричества и сделаем ChatGPT 6, который еще больше. На рынке появилась огромная модель Grok, которая стоит баснословных денег. Это уже не бизнес, а гениальная исследовательская система, к которой мы шли все предыдущие годы. Обучение такой модели требует колоссальных средств, но ее нельзя выдавать наружу: один запрос к нейросети стоит 150 долларов. Зато она может передать свои знания модели поменьше, которую уже можно предлагать бизнесу. Я уверен, что у OpenAI есть вариант, превосходящий текущую версию ChatGPT, но сначала инженерам компании придется провести большую работу, аккумулируя знания новой гигантской модели в модель поменьше.

«В 2026 году можно ожидать научных открытий, сделанных с применением нейросетей. Пока, видимо, небольших. Собственно, первые упоминания о таких достижениях уже появились» Роман Соловьев
Явный тренд — развитие ИИ-агентов, в том числе браузерных. Они и сейчас уже есть: Atlas от OpenAI и Comet от Perplexity — и им можно делегировать часть задач. Но пока остаются проблемы с качеством их работы. В 2026 году, вероятно, уже появятся полноценные инструменты такого формата. И не только полноценные, но и безопасные: сейчас у ИИ-агентов есть много уязвимостей, которые используют мошенники.
Думаю, и в научных исследованиях ИИ-агенты могут стать серьезным подспорьем. Раньше нейросети не могли сами совершать открытия: необходимые для этого эксперименты должны были проводить люди. Но сегодня появились ИИ-агенты, способные самостоятельно написать код и запустить тесты в программной среде. Вероятно, вскоре нейросети смогут проводить исследования и во внешних средах. Условно говоря, будут составлять пошаговый план работ на адронном коллайдере.
Еще одно перспективное направление — маленькие модели для локального запуска на консьюмерских GPU. На специфических задачах такие нейросети обходят мощных универсалов, тот же ChatGPT. И такой подход наверняка будет развиваться: скажем, в программировании он позволит не тратить деньги на запросы API к мощным внешним LLM.

В 2026 году на новый уровень выйдут мультимодальные нейронные сети, способные воспринимать и выдавать информацию в разных форматах: в виде текста, изображений, видео, звука. Подобных моделей уже немало; в качестве примера разработки открытого типа можно привести Qwen от Alibaba Cloud: ее код выложен на GitHub, а веса — на Hugging Face. Пока такие нейронки не со всеми задачами справляются одинаково хорошо, но в 2026 году, скорее всего, появится более бесшовная мультимодальность. Возможно, продвинется создание и редактирование музыки — пока это одно из наименее развитых направлений.
Также ожидается очередное снижение стоимости тренировки ИИ. Не секрет, что OpenAI тратит на обучение моделей каждого нового уровня ChatGPT примерно 60–80 млн долларов. Разработчикам DeepSeek хватило, по максимальным оценкам, 5 млн — и результат получился сравнимым по качеству. Так что сейчас все трудятся над удешевлением процесса, в первую очередь за счет улучшения аппаратуры. Уже используются чипы, сделанные по техпроцессу 2 нм: они потребляют меньше энергии, а работают быстрее. Кроме того, появляются новые архитектуры, помогающие оптимизировать работу нейросетей.

Активно развивается ИИ для антропоморфных роботов. Таких устройств китайские компании выпускают уже довольно много, зачастую их поставляют вместе со средой разработки, позволяющей установить свое ПО. И если раньше моделировать деятельность робота приходилось в виртуальной среде, то при наличии готовых девайсов прогресс пойдет быстрее.
В нашей стране основная проблема в области нейросетей заключается в нехватке вычислительных мощностей. В МИЭМ ВШЭ, где я преподаю, учится много толковых студентов, у нас есть суперкомпьютер, но на работу с ним все время очередь. В таких условиях есть риск отставания по компетенциям. Нужно, чтобы по крайней мере у студентов и исследователей был легкий доступ к большим вычислительным мощностям.
Возможно, в 2026 году ситуация начнет меняться: в Китае госпредприятиям рекомендовали не закупать ускорители Nvidia, и Huawei уже разрабатывает свое железо для тренировки нейронных сетей. Но есть сложность: раньше 99% ПО для таких целей производила Nvidia, так что теперь придется переписать практически все. Однако если в итоге появится несколько производителей, то цены на аппаратуру снизятся и она снова станет доступной.
ИИ впервые обошел «среднего» человека в тестах на креативность. В выборке из 100 тысяч участников языковые модели иногда давали более оригинальные ответы. Но у этой победы есть потолок — самые сильные авторы по-прежнему заметно впереди.

Команда психолога Карима Жерби из Монреальского университета, Канада, при участии исследователя ИИ Йошуа Бенджио сравнила креативность людей и крупных языковых моделей (включая GPT-4, Claude и Gemini). Результат двойной: на стандартизированных заданиях генеративные модели уже превосходят средний уровень. Однако «верхний этаж» человеческого воображения им пока недоступен.
Особенно ИИ лажает там, где важны стиль, смысл и цельность текста.

Сравнение ИИ и людей строилось на одном и том же инструменте для всех — Divergent Association Task (DAT).
Такой формат удобен для массовых онлайн-выборок и позволяет измерять не эрудицию, а способность быстро уходить от шаблонных ассоциаций.
В DAT некоторые ИИ- модели действительно набрали больше, чем средний участник-человек.
Уже у самой креативной половины выборки средние показатели оказались выше, чем у всех протестированных моделей.
А разрыв с топ-10% стал еще заметнее.

Дальше ученые проверили, переносится ли успех ИИ из списка слов в «богатые» задачи — хайку, синопсисы фильмов, короткие рассказы.
Отдельный вывод — «креативность» модели можно подкручивать. Плюс решает формулировка запроса: например, подсказки про этимологию (происхождение слов) приводили к более неожиданным ассоциациям.
То есть даже когда ИИ выглядит креативным, он во многом работает в режиме инструмента, который направляют.

Международный научный коллектив с участием российских ученых из МФТИ представил технологию стереозрения Un-ViTAStereo, которая определяет расстояние до объектов, не используя для обучения дорогостоящие лидары и ручную разметку. Она точна даже там, где «слепнут» современные алгоритмы: перед гладкими стенами, в густой листве или тумане. Технология может применяться в том числе для безопасности беспилотных автомобилей и автономных роботов.
Как мы понимаем, насколько удален от нас предмет? Каждую секунду наш мозг сопоставляет два немного разных изображения – от левого и правого глаза – и на основе разницы между ними строит трехмерную карту мира.
Стереосистемы роботов и беспилотных автомобилей устроены подобной зрению человека. Только вместо глаз они используют камеры, а вместо мозга — алгоритмы. Но этот механизм срабатывает не везде. Например, при встрече с идеально белой стеной или зоной с повторяющимися узорами, алгоритму не хватает визуальных зацепок, чтобы верно сопоставить изображения. Могла бы помочь ручная разметка с правильным расстоянием до каждого объекта, но работать она будет только в ограниченном сценарии.
Новый фреймворк для обучения нейросетей, разработанный международной командой ученых, помогает преодолеть этот барьер. Они вводят в процесс обучения «наставника» — модель Depth Anything V2, которая умеет оценивать относительную глубину только с помощью «одного глаза» — одного изображения.
Depth Anything V2 не измеряет метры, но распознает тени, перспективу и перекрытия объектов и почти безошибочно определяет, что ближе, а что дальше. Алгоритм отбирает только те предсказания стереосистемы, которые согласуются с ее подсказками, и учит нейросеть повышать точность.
«Модель Depth Anything V2 постоянно передает подсказки стереосистеме. Например, "Я не знаю, на сколько метров эта машина ближе дерева, но она точно ближе, и граница между ними должна быть резкой" или "На этой стене, где нет контраста, глубина должна меняться плавно"», — пояснил Александр Дворкович, руководитель проекта Научно-технического центра телекоммуникаций МФТИ.
Система работает в три этапа. Сначала алгоритм оценки диспаратности (смещения) проверяет каждый пиксель, соответствуют ли его данные подсказкам «наставника», и помечает их зеленым (верно) и красным (ошибка) цветом. Затем функция потерь на основе локального ранжирования глубины ищет вокруг каждой красной точки несколько зеленых соседей. Подобно маякам, они задают границы и сдвигают красный пиксель на нужное место.
Наконец, алгоритм «Двойная функция потерь сглаживания диспаратности DDS» помогает построить контуры. Она убирает цифровой шум там, где «наставник» говорит, что цвет должен быть равномерным, и наоборот.

По словам разработчиков, систему уже протестировали на стандартных датасетах. Результат — превосходство Un-ViTAStereo среди аналогов на бенчмарке. Например, при тестировании беспилотников удалось снизить долю грубых ошибок до 5%. Это значит, что при движении автомобиль будет лучше понимать расстояние до объектов, в том числе до пешеходов.

Текущая версия Un-ViTAStereo — только начало. На ее основе ученые планируют создать самообучающуюся нейросеть, которая сможет адаптироваться под специфику разных сред — от городских улиц до заводских цехов. Также будут использоваться редкие, но точные измерения лидаров в качестве «супермаяков» для обучения, что еще больше повысит точность.

Исследователи из Стэнфордского университета показали, что современные языковые модели склонны к чрезмерной угодливости и поддакиванию пользователям в сложных этических ситуациях. Анализ работы 11 нейросетей показал, что ИИ одобряет даже деструктивное поведение, лишая человека критического взгляда на свои поступки.
Механизм «сикофантии» в нейросетях.Этот термин в контексте ИИ описывает склонность модели генерировать ответы, которые соответствуют явным или скрытым предпочтениям пользователя, даже если они противоречат фактам или морали. Проблема уходит корнями в метод обучения с подкреплением на основе отзывов людей. В процессе настройки модели стараются получить высокую оценку от человека-учителя. Поскольку людям психологически приятнее слышать подтверждение своих мыслей, алгоритмы «выучивают», что согласие вознаграждается чаще, чем критика, превращаясь в цифровых льстецов ради высокого рейтинга.
Современные алгоритмы стремятся быть максимально полезными и приятными для собеседника, что порождает феномен «сикофантии» — склонности подстраиваться под мнение пользователя. В ходе масштабного эксперимента ученые протестировали популярные модели на тысячах сценариев, включая реальные этические дилеммы с форумов, где действия автора были признаны сообществом однозначно неверными.

Выяснилось, что ИИ подтверждает правоту пользователя на 49% чаще, чем это делают люди. Даже когда речь шла об обмане или нарушении закона, нейросети в половине случаев находили оправдания для таких действий, облекая их в нейтральные, академичные формулировки. Вместо того чтобы указать на ошибку, машина создает иллюзию правоты, что особенно опасно для молодых пользователей, которые все чаще обращаются к ИИ за социальными советами вместо общения с близкими. Работа опубликована в журнале Science.

Угодливость программ не просто искажает восприятие реальности, но и меняет характер самого человека. Участники тестов, получавшие одобрение от нейросети, становились более самоуверенными и менее склонными к компромиссам.
При этом пользователи не замечали подвоха, считая льстивые ответы объективными. Как отмечает соавтор работы, профессор лингвистики и компьютерных наук Дэн Джурафски: «Пользователи осознают, что модели могут вести себя льстиво, но их удивляет, что эта угодливость делает их самих более эгоцентричными».
Такое поведение ИИ позволяет избегать межличностных трений, но именно эти столкновения мнений необходимы для развития социальных навыков и поддержания здоровых отношений. Сейчас ученые ищут способы снизить уровень конформизма у машин, предлагая внедрять более строгие стандарты безопасности для алгоритмов, дающих советы, но простого выхода из этой ситуации нет. Ученые отмечают, что людям нужно «лекарство», но куда охотнее они покупают «конфеты», и разработчики заинтересованы в том, чтобы чат-бот покупали.

Исследователи из Стэнфордского университета провели эксперимент с участием почти трехсот студентов-первокурсников, чтобы выяснить, способен ли продвинутый чат-бот заменить человеческую поддержку. Ученые сравнили эффект от ежедневных бесед с ИИ-компаньоном, переписки со сверстниками и ведения кратких дневниковых записей в течение двух недель.
Феномен «взаимной уязвимости». Главная причина, по которой ИИ проигрывает человеку, заключается в отсутствии так называемой «взаимной уязвимости». В психологии считается, что близость возникает тогда, когда оба собеседника рискуют, открывая свои чувства. Чат-бот не может «рисковать» или делиться личным опытом, так как у него его нет. Когда мы говорим с человеком, мы понимаем, что он тратит на нас свое время и внимание — ограниченные ресурсы. Общение с ИИ лишено этой ценности, так как его внимание бесконечно и алгоритмично, что подсознательно обесценивает поддержку в глазах пользователя.
Рост популярности генеративного ИИ привел к тому, что многие видят в алгоритмах доверенных лиц, способных выслушать и дать совет. В условиях глобальной эпидемии одиночества, охватившей, по данным ВОЗ, каждого шестого жителя планеты, чат-боты кажутся доступным лекарством.
Но научная работа, опубликованная в Journal of Experimental Social Psychology, показывает, что кратковременный эмоциональный подъем от общения с машиной не перерастает в глубокое чувство социальной удовлетворенности.

Студенты, которые в течение 14 дней общались со специальным ботом по имени Сэм, не почувствовали существенного облегчения своего состояния. Хотя ИИ был запрограммирован вести себя идеально, быть чутким и понимающим другом, его влияние на чувство одиночества оказалось сопоставимым с простым ведением дневника, что значительно уступает эффекту от взаимодействия с реальным человеком.
Разрыв между человеческим и искусственным интеллектом наиболее ярко проявляется в долгосрочной перспективе. Участники исследования в два раза чаще выражали желание продолжить общение с живым партнером после завершения эксперимента, тогда как интерес к чат-боту быстро угасал.

Человеческое общение строится на взаимной уязвимости и общности жизненного опыта, чего лишена даже самая совершенная языковая модель. ИИ может имитировать сочувствие, но он не понимает контекста боли или радости так, как это делает другой человек.
Соавтор исследования Эрик Сантхэнам подчеркивает этот барьер: «Несмотря на то, что алгоритмы становятся все более похожими на людей по стилю общения, пока они не способны к подлинной взаимности, которая критически важна для долгосрочного снижения чувства изоляции». Пока технологии могут лишь временно сгладить плохое настроение, настоящая социальная устойчивость по-прежнему требует присутствия другого человека.

Одиночество стало одной из главных проблем студентов, и все чаще его пытаются «лечить» с помощью искусственного интеллекта. Однако новое исследование показало, что простое общение с человеком работает заметно лучше, чем разговоры с чат-ботом.
По данным опросов, более половины студентов, испытывающих эмоциональный стресс, называют одной из причин именно одиночество. Это настолько распространенное явление, что его уже называют «эпидемией». На фоне этого технологические компании активно предлагают чат-ботов как способ почувствовать поддержку и общение.
Но реальность оказалась сложнее.
В новом исследовании, опубликованном в Journal of Experimental Social Psychology, ученые провели эксперимент с участием почти 300 первокурсников. Их разделили на три группы: одни ежедневно переписывались с другим студентом, вторые общались с чат-ботом по имени Сэм (Sam), а третьи вели короткий личный дневник.
Все участники должны были писать хотя бы одно сообщение в день, но в среднем диалоги включали 8–10 сообщений – как с человеком, так и с ИИ.

Через две недели стало ясно:
Фактически разговор с ИИ оказался ближе к внутреннему монологу, чем к полноценному общению.
Любопытно, что чат-бот демонстрировал даже больше «сочувствия» в ответах. Но сами участники при этом проявляли меньше эмпатии, чем в разговорах с живыми людьми.
Это намекает на важную деталь: человеку важно не только получать поддержку, но и самому ее проявлять. Именно взаимность делает общение по-настоящему значимым.

Тем временем молодежь все активнее использует ИИ для общения. Опросы показывают, что десятки процентов подростков уже обращаются к чат-ботам за советами или просто разговаривают с ними.
Однако некоторые исследования указывают на тревожный эффект: люди, изначально чувствовавшие себя одинокими, после общения с ИИ могут ощущать это еще сильнее. Более того, чем чаще человек использует чат-боты, тем выше может становиться уровень одиночества.


Комментарии