Умелец в области электроники, известный как CreativelyBankrupt, представил необычного робота-компаньона по имени Sparky. Он способ работать полностью автономно, без подключения к интернету, сотовой сети или Wi-Fi. Главная особенность помощника в том, что он умещается в обычном чемодане и при этом оснащён более чем 30 датчиками.
В основе Sparky лежит одноплатный компьютер Jetson Orin NX Super с 16 ГБ оперативной памяти от NVIDIA. Вся обработка данных происходит локально – робот запускает языковую модель Gemma 4B. Контекст разговора составляет 12 тысяч токенов, что позволяет Sparky помнить довольно длинные диалоги без потери нити беседы.
Производительность у системы достаточно приличная для портативного решения. Время до первого токена составляет около 200 миллисекунд, а скорость генерации держится на уровне 14–15 токенов в секунду.
Речь распознаётся через SenseVoiceSmall, а синтез голоса выполняет Piper, синхронизированный с анимацией рта на движке PixiJS с частотой обновления 43 Гц. Распознавание текста на изображениях и компьютерное зрение встроены прямо в Gemma 4.
Хотя Sparky умещается в чемодан, широкий набор сенсоров обеспечивает ему полноценное восприятие окружающей среды даже вдали от любой инфраструктуры. Управлять им можно вручную с помощью набора кнопок, джойстика и аналогового энкодера.
Австралийский режиссёр и сценарист Алекс Пройас, известный по "Я, роботу", "Ворону" и "Тёмному городу", готовится вернуться к большому кино впервые за десять лет. Его новой работой станет мрачная антиутопичная сатира "Heaven" ("Рай").
Производством займётся студия Ex Machina, которая задействует собственную ИИ-технологию для создания визуальной части фильма. По заявлению компании, инструмент позволяет "создавать масштабные миры при разумном бюджете, сохраняя приоритет настоящих актёров, написанных людьми историй и производственных практик, соответствующих правилам гильдий".
Над идеей "Рая" Пройас работал несколько лет. В центре сюжета будет отчаявшийся бюрократ, который бежит от рушащейся жизни и оказывается в технологически совершенной загробной жизни.
Однако вскоре выясняется, что рай представляет собой "тщательно сконструированную иллюзию с ужасающими последствиями". Фильм описывают как мрачную сатиру "в традиции "Бразилии" Терри Гиллиама" – культовой антиутопии 1985 года о тоталитарной бюрократической системе.
По словам самого Пройаса, именно ИИ должен помочь воплотить то иммерсивное видение, которое он задумал для картины.
Студия Revolution Software, известная серией классических приключенческих игр Broken Sword, объявила об отказе от технологий искусственного интеллекта при создании ремастера Broken Sword: The Smoking Mirror. Решение было принято после неудачного опыта с ИИ-апскейлингом в ремастере первой части серии, вышедшем в 2024 году. Фанаты встретили новость с энтузиазмом – кампания на Kickstarter достигла заявленной цели всего за 15 минут.
Ремастер оригинальной Broken Sword: Shadow of the Templars в целом получил тёплый приём и "крайне положительные" отзывы в Steam, несмотря на использование ИИ-апскейлинга. Однако для самих разработчиков технология оказалась скорее проблемой, чем решением. Глава Revolution Software Чарльз Сесил ещё в прошлом году рассказывал, что студия пыталась использовать ИИ "правильно" – была обучена внутренняя модель исключительно на собственных работах студии для обработки изображений. Но результат разочаровал.
Итог оказался не слишком удовлетворительным, так как в изображениях было недостаточно деталей.
Для ремастера второй части, получившего подзаголовок Reforged, Revolution выбрала принципиально иной подход.
В этой игре более 55 000 уникальных кадров анимации, и она создана командой талантливых классических аниматоров, которые перерисовали и переанимировали игру кадр за кадром. Добавление тонкой, контекстно-зависимой характеризации персонажей и человеческих выражений – это то, что ИИ не может делать и никогда не сможет.
На странице кампании студия также пояснила, почему отказалась от ИИ-инструментов:
В итоге это была куча работы, которую можно было бы, честно говоря, потратить непосредственно на игру – так что именно это мы и делаем на этот раз! Никакого ИИ, только люди.
Изначальная цель кампании на Kickstarter была довольно скромной – 57 тысяч евро. Сумма была собрана менее чем за 15 минут после старта. На момент написания материала фанаты уже надонатили почти 400 тысяч евро, многократно превысив заявленную цель задолго до окончания кампании в следующем месяце. Можно делать собственные выводы о том, насколько мгновенный успех кампании связан именно с отказом от ИИ, но расположение сообщества к новому ремастеру определённо велико.
Стоит отметить, что ИИ-апскейлинг действительно показывает впечатляющие результаты в определённых случаях – например, технология DLSS от Nvidia. Однако когда речь идёт о масштабировании ретроигр с низким разрешением для современных дисплеев, результат чаще всего выглядит неубедительно. Разработчики из Revolution, очевидно, пришли к такому же заключению и решили вложить усилия живых художников в то, чтобы вернуть классику серии Broken Sword так, как она того заслуживает.
Роботу Mitsubishi Electric потребовалось 0,305 секунды, чтобы собрать головоломку, что на 0,075 секунды меньше существующего рекорда, установленного роботом Массачусетского технологического института в 2018 году. Как видно из приведенного ниже видео, это буквально ситуация, когда вы моргаете и не замечаете этого, учитывая, что в среднем моргание занимает от 100 до 400 миллисекунд.
Обычная летняя проблема превратилась в инженерную задачу для специалиста по компьютерному зрению. Стивен Чен, работающий в области компьютерного зрения и робототехники, задокументировал, как создавал то, что сам называет "идеальным истребителем комаров".
В основе гаджета лежит связка из системы обнаружения на глубоком обучении и лазерного наведения.
Фундаментом стала визуальная модель, которую Чен обучил на собственном датасете комаров. Для сбора данных он использовал зеркальную камеру с длиннофокусным зум-объективом, снимая детальные изображения насекомых. Та же камера служит и инструментом обучения, и основным сенсором обнаружения.
Процесс сбора данных дался непросто. По словам Чена, после него на нём остались "бесчисленные укусы по всему телу". Снимки разметили и скормили модели глубокого обучения, чтобы та научилась распознавать комаров в полёте.
Обучение оказалось ресурсоёмким. Чен отметил, что эта задача "как следует нагрузила видеокарту", а итоговую точность распознавания назвал "вполне хорошей". Этого хватило, чтобы уверенно выделять комаров на фоне помех.
Дальше дело дошло до боевой части. Лазер настроили так, чтобы "мгновенно превращать комаров в поджаренных", и закрепили на высокоточной промышленной поворотной платформе. Платформа позволяет лазеру быстро и точно двигаться, отслеживая цели, найденные системой зрения.
В итоге получился замкнутый контур, где камера находит комара, модель подтверждает цель, а механика в реальном времени наводит и стреляет. В отличие от обычных уничтожителей насекомых, работающих на пассивном привлечении, эта система активно отслеживает и поражает отдельных особей.
Безопасность Чен заложил отдельно. Он добавил вторую широкоугольную камеру для обнаружения людей и горючих материалов, и при любом пересечении такого объекта с лазерной целью питание на лазер не подаётся. После сборки и тестов Чен заявил, что за одну ночь работы все комары в его жилище были "успешно уничтожены".
У идеи есть и коммерческий аналог. Гаджет под названием Photon Matrix использует лидарный сканер в связке с управляемым гальванометром лазером и, по заявлениям создателей, поражает до 30 комаров в секунду. Сам Чен тем временем уже показал версию с тепловизором, гармоническими приводами, сервомоторами и усиленным алюминиевым подвесом.
Oracle провела масштабное сокращение штата, затронувшее от 10 до 30 тысяч человек. Информацию подтвердил один из сотрудников компании в разговоре с BBC.
Среди уволенных – старшие инженеры, архитекторы, руководители операционных подразделений, программные менеджеры и технические специалисты. Майкл Шеперд, старший менеджер по операциям в Oracle, опубликовал заявление, в котором подробно описал ситуацию.
Сегодня Oracle провела значительное сокращение штата, которое затронуло одних из самых талантливых, преданных и высокоэффективных людей, с которыми мне посчастливилось работать. Скажу прямо – это не было связано с результатами работы. Уволенных отпустили не из-за того, что они сделали или не сделали.
Ситуация выглядит особенно противоречиво на фоне агрессивной экспансии Oracle в сфере ИИ. На протяжении последнего года компания активно инвестировала в ИИ-инфраструктуру и наращивала мощности дата-центров.
Oracle даже заявляла о готовности искать альтернативы чипам NVIDIA для выполнения контрактов, среди которых – участие в гигантской сделке с OpenAI на 300 миллиардов долларов.
Сокращение подпитывает дискуссию о том, не начинает ли ИИ-индустрия демонстрировать первые признаки нестабильности. Существует мнение, что технологические компании рассчитывают компенсировать потерю рабочей силы именно за счёт ИИ-инструментов. Вопрос в том, какими будут последствия такой зависимости от ИИ.
Дополнительный контекст добавляют и недавние события вокруг OpenAI. Компания свернула приложение Sora, а Disney вышла из инвестиционной сделки на миллиард долларов.
Оба случая можно трактовать как сигнал напряжения на ИИ-рынке – или как минимум внутри самой OpenAI. Впрочем, картина неоднозначна – буквально в тот же период OpenAI закрыла раунд финансирования на 110 миллиарда долларов, так что недостатка в инвесторах и средствах компания явно не испытывает.
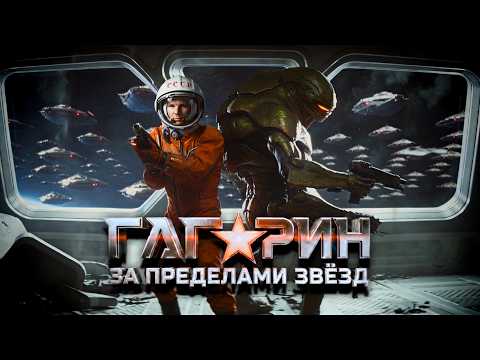
Студия Noizlab под руководством режиссера Павла Жигарева представила концептуальный научно-фантастический трейлер под названием "Гагарин: За пределами звёзд". Проект переосмысливает историческое событие 1961 года, превращая первый полет человека в космос в начало межпланетного приключения.
Все сделано с помощью DeepSeek, но выглядит все равно очень удачно. Самое удивительное, что на трейлер на накинулись интернет-луддиты, которые ненавидят все, что сделано нейросетями.
По сюжету воображаемой картины Юрий Гагарин во время легендарного полета обнаруживает голографический барьер, скрывающий истинную структуру Солнечной системы. За искусственным экраном оказывается обширная межпланетная империя, населкнная множеством инопланетных цивилизаций. Галактическое сообщество живкт по строгому закону – цивилизации, не достигшие внутренней гармонии и мира, остаются изолированными в пределах своих планет.
Прорыв советского космонавта становится нарушением этого закона. Корпус солнечных стражей захватывает Гагарина и доставляет к Старшим для стирания памяти, однако ему удактся вырваться на свободу. Вместо возвращения домой космонавт отправляется в путешествие по галактике, пытаясь понять, как человечество может достичь необходимой гармонии для выхода за пределы своего "аквариума".
Концепция трейлера подразумевает, что пока на Земле считали Гагарина погибшим, он провёл 65 лет, путешествуя по вселенной и скрываясь от Солнечной гвардии. Проект представляет собой творческую интерпретацию исторических событий через призму научной фантастики, смешивая реальные факты с вымышленными элементами космической оперы. В видео множестов отсылок на "Звездные войны", "Чужого" и другую фантастику.
Как технологии влияют на медицину — от приема в поликлинике до клинических исследований
Быстрое принятие решений врачами — ключ к благополучию пациентов. Задержки в обследованиях, постановке диагноза и назначении лечения могут стоить здоровья и даже жизни. Объем работы в медицине огромен, и врачи не могут позволить себе тратить время на рутину — на помощь приходят технологии. С их помощью эксперты быстрее анализируют данные, определяют диагноз и разрабатывают новые методы лечения и лекарства.
Внедряют такие технологии крупные ИТ-компании вместе с медицинскими специалистами. Так, в числе проектов Центра технологий для общества Yandex Cloud решение для раннего выявления spina bifida — тяжелой патологии развития позвоночника и спинного мозга у плода — на УЗИ беременных и внедрение генеративных технологий для ускорения обработки заявок на клинические исследования.
В этом материале вместе с экспертами Yandex Cloud мы покажем, как искусственный интеллект меняет российскую и международную медицину: от приема у врача до фундаментальных исследований.
В кабинете врача
Заглянем в кабинет врача районной поликлиники. Широкий стол, монитор, электронная карта пациента, пачка бланков, распечатанные рекомендации. На прием от 14 до 22 минут.
Пациент рассказывает врачу о своих жалобах, врач внимательно слушает, задает уточняющие вопросы и изучает предыдущую историю болезни. До двух третей времени клинической работы уходит не на диагноз и лечение, а на ввод данных, повторное чтение электронной медицинской карты (ЭМК) и поиск информации в разросшихся массивах. Все эти записи надо внимательно прочитать за ограниченное время приема. Результат — когнитивная перегрузка и снижение качества приема как для пациента, так и для врача: чем больше данных, тем меньше внимания уделяется главному — самому пациенту.
Здесь как раз может помочь искусственный интеллект. Обработка медицинских текстов — одна из задач, где он особенно эффективен. ИИ может искать важное, структурировать данные и предлагать ответы на конкретный запрос. Это особенно важно при назначении лекарств. Подбор препарата и его дозировки зависит от множества факторов: результатов лабораторных анализов, анамнеза, возраста, сопутствующих заболеваний, аллергий. Для эффективной и безопасной работы с учетом новейших рекомендаций врачу нужен помощник — им может стать ИИ.
Например, в Сингапурской клинической больнице взяли 91 сценарий ошибок при назначении лекарств из 16 медицинских специальностей, от кардиологии до онкологии, и создали решение на базе RAG (Retrieval Augmented Generation — генерация с дополненной выборкой). Этот подход позволяет большим языковым моделям искать ответы по данным из внешних источников с помощью поиска по загруженным в нее материалам — сценариям ошибок. Режим совместной работы ИИ и фармацевта, где фармацевт принимал финальное решение, показал наилучший результат: точность составила 61 процент, что на 15 процентов выше по сравнению с работой фармацевта без помощи ИИ (46 процентов).
Заключение от врача получено. Но что делать с фразой вроде «диффузная гипоэхогенность щитовидной железы с очаговыми изменениями до восьми миллиметров» — особенно если вы не эндокринолог? Пациенты все чаще получают доступ к своим данным напрямую, но сталкиваются со стеной из сокращений, латинских терминов и узкопрофессиональных формулировок. Результат — тревога вместо понимания, а врач тратит время приема не на лечение и диагностирование, а на перевод с «медицинского на человеческий». Генеративные технологии ИИ здесь работают как редактор: они не упрощают — они переформулируют, сохраняя смысл.
Например, чтобы снизить нагрузку на урологов и одновременно повысить качество информирования пациентов, в 2024 году специалисты Kaiser Permanente в США протестировали два чат-бота на базе GPT для ответов на типичные вопросы пациентов о доброкачественной гиперплазии простаты. Первый — на базе стандартного ChatGPT, второй — специализированная версия SurgiChat с дополнительным доступом к медицинской литературе через технологию RAG.
В работе также участвовали четыре практикующих уролога, чьи ответы использовались как эталон для оценки качества. Результаты показали: по точности передаваемой информации чат-боты и врачи были сопоставимы (4,5 против 4,6 балла из 6).
При этом ИИ не делает клинических выводов и не ставит диагноз — он генерирует справочную информацию и пояснения, которые помогают врачу и пациенту быстрее разобраться в данных. В результате врач может писать не как автор с нуля, а как редактор и куратор готового черновика — быстро проверяя формулировки, убирая лишнее и добавляя клинически значимые уточнения. Такой формат снижает административную нагрузку и высвобождает время приема для клинического мышления и общения с пациентом.
В научном центре
Когда врач ставит диагноз, он опирается на жалобы пациента, анамнез и результаты обследований. Ключевую роль здесь играют медицинские изображения — УЗИ, МРТ, КТ, особенно при заболеваниях сердца или опухолей. Их нужно быстро и точно интерпретировать, но это требует опыта и времени.
Поэтому в диагностике все активнее применяют системы компьютерного зрения. Они выступают как вспомогательные инструменты: ускоряют разбор снимков, выделяют значимые области и снижают риск пропустить важную деталь. Такая вторая «пара глаз» помогает врачу принимать более обоснованные решения.
Один из примеров — инструмент для раннего выявления признаков spina bifida у плода, разработанный специалистами Центра технологий для общества Yandex Cloud, Школы анализа данных и НМИЦ акушерства, гинекологии и перинатологии имени академика В. И. Кулакова при поддержке фонда «Спина бифида».
Кирилл Костюков, заведующий отделением ультразвуковой и функциональной диагностики ФГБУ «НМИЦ АГП им. В. И. Кулакова» Минздрава России, эксперт благотворительного фонда «Спина бифида»
Spina bifida — редкая врожденная патология. Она связана с нарушением формирования позвоночника и спинного мозга, что вызывает нарушение функции (паралич) нижних конечностей и нарушает работу тазовых органов. В тяжелых случаях это приводит к инвалидности.
Ранняя ультразвуковая диагностика порока нередко вызывает сложности. На результат влияют множество факторов от положения плода до качества оборудования и опыта врача. Признаки дефекта могут быть малозаметными, из-за чего диагноз нередко ставят на поздних сроках беременности или даже после рождения.
Около 40 процентов случаев выявляют слишком поздно — в третьем триместре беременности. Из-за чего существует вероятность, что пациентку уже не успеют направить в учреждение, где новорожденному сразу окажут необходимую нейрохирургическую помощь. Кроме того, при ранней диагностике можно провести внутриутробную операцию на сроке 22–26 недель. Данная операция, несмотря на риски, имеет ряд преимуществ по сравнению с лечением после рождения. Внутриутробная хирургия Spina bifida позволяет снизить вероятность развития гидроцефалии (водянки головного мозга), а также улучшить функцию нижних конечностей и органов малого таза.Кирилл Костюков, заведующий отделением ультразвуковой и функциональной диагностики в НМИЦ АГП имени В. И. Кулакова
Эксперты обучили модель на девятнадцати тысячах размеченных УЗИ-изображений. Алгоритмы определяют область интереса на изображении, оценивают его качество. Затем сверточные нейросети классифицируют изображение на нормальное или патологическое, таким образом, определяется порок развития. Результат врач получает в виде отчета, где подсвечены проблемные области и указана вероятность наличия патологии в процентах. Это позволяет оценить риск и уточнить диагноз. В данный момент разработка доступна врачам для тестирования в научно-исследовательских целях бесплатно, а ее код лежит в открытом репозитории.
Интерфейс приложения для анализа признаков патологии центральной нервной системы на УЗИ беременных женщин
В перспективе использование данной технологии позволит врачам своевременно диагностировать Spina Bifida, это даст возможность профилактировать рождение детей с патологией, проводить внутриутробные операции и максимально подготовить родителей к рождению ребенка с таким диагнозом. Когда диагноз ставят на ранних сроках, у будущих родителей есть время адаптироваться и подготовиться: эмоционально и организационно.Инна Инюшкина, основательница фонда «Спина бифида»
В 2025 году команда Yandex Cloud совместно со специалистами Санкт-Петербургского педиатрического университета разработала нейросеть для автоматизированного анализа МРТ головного мозга младенцев. Сервис помогает прогнозировать патологии, которые возникают из-за повреждения или аномального развития мозга. Например, его можно использовать при подозрении на детский церебральный паралич (ДЦП).
Это заболевание проявляется двигательными расстройствами, нарушением мышечного тонуса, а также когнитивными и сенсорными трудностями и остается одной из главных причин детской инвалидности. Терапия может заметно улучшить состояние, но диагноз надо поставить как можно раньше. А это трудно: первые изменения мозга на МРТ едва заметны и требуют от врача опыта и времени. Интерпретация может растянуться на часы или даже дни, каждый из которых снижает потенциал реабилитации.
Интерфейс сервиса, который помогает помогает врачам анализировать результаты МРТ мозга младенцев
Модель обучили на полутора тысячах анонимизированных МРТ-снимков из Педиатрического университета и данных международного конкурса MICCAI Grand Challenge. Пайплайн включает несколько моделей компьютерного зрения:
BIBSNet — для предварительной обработки и стандартизации изображений мозга младенцев;
U-Net — популярная в медицинской визуализации архитектура для сегментации структур мозга.
Сервис графически выделяет белое и серое вещество головного мозга и выполняет количественный подсчет объема этих структур, помогая врачу быстрее оценить состояние тканей. Работает все через веб-интерфейс: врач загружает снимки, система обрабатывает данные и формирует результат за несколько минут, а не дней.
В медицине самые сложные задачи не требуют промедления. Главное, чтобы собралась команда, которой действительно нужен результат. Поэтому проект начался на пересечении кафедры и отделения лучевой диагностики, где исторически собирались данные по детям: МРТ головы в динамике. Мы быстро смогли начать сбор данных и выстраивание новых процессов. Сейчас система используется в исследовательских целях и еще не внедрена в клиническую практику, но руководство Университета поддерживает нас и дает свободу для развития.
Пётр Пузанов, директор центра цифровых технологий Санкт-Петербургского педиатрического университета
В медико-биологической лаборатории
Взглянем на медицину под другим углом. Из лаборатории, где рождаются будущие лекарства. Они начинают свой путь с проектирования терапевтической молекулы и ее испытания на модельных объектах в лаборатории.
Но объем данных растет быстрее, чем их можно проанализировать вручную. Современные методы — мультиомика, высокопроизводительная визуализация, анализ тысяч генов и белков одновременно — дают гигабайты информации. Использование методов машинного обучения открывает новые возможности для быстрого и системного анализа таких массивов данных.
Методы машинного обучения применяются в биомедицинских исследованиях для анализа больших экспериментальных и клинических наборов данных — в том числе при поиске потенциальных биомаркеров, сравнении отклика на терапию в разных группах пациентов и приоритизации терапевтических мишеней. Речь идет не о готовых клинических решениях, а о поддержке исследовательской работы и генерации гипотез, которые затем проверяются специалистами.
А появление моделей, способных предсказывать трехмерную структуру белков по их аминокислотной последовательности, стало прорывом в структурной биологии и изменило подход к разработке лекарств. Теперь ученые могут заранее оценить, какие соединения будут работать, и сосредотачиваться только на них. Это сокращает время и стоимость исследований и снижает риск неудач на поздних стадиях испытаний.
В феврале 2025 года Институт исследований искусственного интеллекта Университета Цинхуа совместно с Beijing Shuimu Molecule представил обновленную версию мультимодальной биомедицинской модели BioMedGPT-R1. Система с 17 миллиардами параметров построена на базе DeepSeek-R1-Distill-Qwen-14B и предназначена для работы с медицинскими задачами, где нужно одновременно анализировать тексты, изображения и другие типы биомедицинских данных.
Модель обучалась так, чтобы связывать между собой разные формы медицинской информации — научные статьи, описания экспериментов и визуальные данные — и использовать их при ответах на вопросы и анализе исследований. Благодаря этому она показывает качество, сопоставимое с коммерческими системами, в задачах биомедицинского вопросно-ответного анализа.
BioMedGPT-R1 также проверяли на экзамене USMLE — стандартизированном тесте для получения медицинской лицензии в США, который часто используют как ориентир для оценки способности моделей рассуждать в клиническом контексте. Модель набрала 67,1 процента правильных ответов, что указывает на ее умение работать с медицинской терминологией и клиническими сценариями. Способность объединять разнородные биомедицинские данные делает модель перспективным инструментом поддержки исследовательской работы: в анализе научных публикаций, планировании экспериментов и интерпретации их результатов.
Возможно, применение ИИ в разработке лекарств — один из самых значимых прорывов в медицине за последние десятилетия.
В клинических испытаниях
Созидание медицинских инноваций давно вышло за пределы лабораторных стен. То, что начинается с экспериментов на животных моделях и бесчисленных серий аналитических тестов, еще не является настоящим прорывом. Новая разработка — будь то лекарственный препарат, медицинское устройство или методика — обретает свою подлинную научную состоятельность и практическую пользу лишь тогда, когда проходит испытание «клиникой».
Именно клинические исследования становятся финальной и наиболее ответственной стадией рождения медицинского открытия: когда к процессу присоединяются реальные люди — добровольцы, пациенты, участники исследования. Здесь инновация сталкивается с живой человеческой физиологией, многообразием реакций, сложностью реальной жизни — и только выдержав это испытание, она может стать частью современной медицины.
Модель обучили на полутора тысячах анонимизированных МРТ-снимков из Педиатрического университета и данных международного конкурса MICCAI Grand Challenge. Пайплайн включает несколько моделей компьютерного зрения:
BIBSNet — для предварительной обработки и стандартизации изображений мозга младенцев;
U-Net — популярная в медицинской визуализации архитектура для сегментации структур мозга.
Сервис графически выделяет белое и серое вещество головного мозга и выполняет количественный подсчет объема этих структур, помогая врачу быстрее оценить состояние тканей. Работает все через веб-интерфейс: врач загружает снимки, система обрабатывает данные и формирует результат за несколько минут, а не дней.
В медицине самые сложные задачи не требуют промедления. Главное, чтобы собралась команда, которой действительно нужен результат. Поэтому проект начался на пересечении кафедры и отделения лучевой диагностики, где исторически собирались данные по детям: МРТ головы в динамике. Мы быстро смогли начать сбор данных и выстраивание новых процессов. Сейчас система используется в исследовательских целях и еще не внедрена в клиническую практику, но руководство Университета поддерживает нас и дает свободу для развития.
Пётр Пузанов, директор центра цифровых технологий Санкт-Петербургского педиатрического университета
В медико-биологической лаборатории
Взглянем на медицину под другим углом. Из лаборатории, где рождаются будущие лекарства. Они начинают свой путь с проектирования терапевтической молекулы и ее испытания на модельных объектах в лаборатории.
Но объем данных растет быстрее, чем их можно проанализировать вручную. Современные методы — мультиомика, высокопроизводительная визуализация, анализ тысяч генов и белков одновременно — дают гигабайты информации. Использование методов машинного обучения открывает новые возможности для быстрого и системного анализа таких массивов данных.
Методы машинного обучения применяются в биомедицинских исследованиях для анализа больших экспериментальных и клинических наборов данных — в том числе при поиске потенциальных биомаркеров, сравнении отклика на терапию в разных группах пациентов и приоритизации терапевтических мишеней. Речь идет не о готовых клинических решениях, а о поддержке исследовательской работы и генерации гипотез, которые затем проверяются специалистами.
А появление моделей, способных предсказывать трехмерную структуру белков по их аминокислотной последовательности, стало прорывом в структурной биологии и изменило подход к разработке лекарств. Теперь ученые могут заранее оценить, какие соединения будут работать, и сосредотачиваться только на них. Это сокращает время и стоимость исследований и снижает риск неудач на поздних стадиях испытаний.
В феврале 2025 года Институт исследований искусственного интеллекта Университета Цинхуа совместно с Beijing Shuimu Molecule представил обновленную версию мультимодальной биомедицинской модели BioMedGPT-R1. Система с 17 миллиардами параметров построена на базе DeepSeek-R1-Distill-Qwen-14B и предназначена для работы с медицинскими задачами, где нужно одновременно анализировать тексты, изображения и другие типы биомедицинских данных.
Модель обучалась так, чтобы связывать между собой разные формы медицинской информации — научные статьи, описания экспериментов и визуальные данные — и использовать их при ответах на вопросы и анализе исследований. Благодаря этому она показывает качество, сопоставимое с коммерческими системами, в задачах биомедицинского вопросно-ответного анализа.
BioMedGPT-R1 также проверяли на экзамене USMLE — стандартизированном тесте для получения медицинской лицензии в США, который часто используют как ориентир для оценки способности моделей рассуждать в клиническом контексте. Модель набрала 67,1 процента правильных ответов, что указывает на ее умение работать с медицинской терминологией и клиническими сценариями. Способность объединять разнородные биомедицинские данные делает модель перспективным инструментом поддержки исследовательской работы: в анализе научных публикаций, планировании экспериментов и интерпретации их результатов.
Возможно, применение ИИ в разработке лекарств — один из самых значимых прорывов в медицине за последние десятилетия.
В клинических испытаниях
Созидание медицинских инноваций давно вышло за пределы лабораторных стен. То, что начинается с экспериментов на животных моделях и бесчисленных серий аналитических тестов, еще не является настоящим прорывом. Новая разработка — будь то лекарственный препарат, медицинское устройство или методика — обретает свою подлинную научную состоятельность и практическую пользу лишь тогда, когда проходит испытание «клиникой».
Именно клинические исследования становятся финальной и наиболее ответственной стадией рождения медицинского открытия: когда к процессу присоединяются реальные люди — добровольцы, пациенты, участники исследования. Здесь инновация сталкивается с живой человеческой физиологией, многообразием реакций, сложностью реальной жизни — и только выдержав это испытание, она может стать частью современной медицины.
Инициация клинического испытания — сложный процесс, требующий согласования с регуляторными органами, четкого регламента и официального разрешения на начало работы.
Координация клинических исследований и экспертиза документации — самая трудоемкая часть работы. Нужно учитывать требования регуляторов, этические стандарты, правовые нюансы и одновременно обеспечивать оперативность. Каждое исследование уникально, и ошибки здесь недопустимы.Артём Полторацкий, руководитель отдела организации клинических исследований в НМИЦ онкологии им. Н. Н. Петрова Минздрава России
Для запуска клинического исследования нужно подготовить обширный пакет документов, включающий утвержденный протокол исследования, досье исследуемого препарата или изделия, форму информированного согласия пациента, финансово-договорную документацию и положительное заключение локального этического комитета(ЛЭК).
С увеличением числа заявок на запуск испытаний возрастает и нагрузка на экспертов ЛЭК. Каждая заявка может включать сотни страниц, и трудности в обработке таких объемов информации приводят к задержкам на одобрение и повышают риск ошибок.
По словам Артёма Полторацкого, согласование документов одновременно по нескольким контурам приводит к дублированию требований регуляторов, разночтениям в нормах, а также ошибкам из-за недостаточной автоматизации и человеческого фактора. Это создает серьезные сложности в работе.
Из-за высоких организационных требований клинические испытания представляют собой трудоемкий и долгий процесс: разработка одного лекарственного препарата, его одобрение и выход на рынок может занимать 15 лет и стоить полтора-два миллиарда долларов.
В ответ на эту проблему НМИЦ онкологии имени Н. Н. Петрова внедрил решение для проверки пакета документов в ЛЭК на базе генеративной модели YandexGPT, который входит в платформу Yandex AI Studio.
Решение работает с загружаемыми заявками на клинические исследования — протоколами, описаниями препаратов, формами информированного согласия и сопроводительными материалами, анализируя их на лету. Специфические требования ЛЭК и правила проверки задаются через структурированные чек-листы и промпты. Решение интегрировано с информационными системами центра, что обеспечивает непрерывную обработку данных и существенно снижает объем ручной работы.
Как работает инструмент:
Документы заявки загружают в систему в электронном виде.
YandexGPT анализирует содержание документов, выявляя ключевые элементы, такие как цели исследования, методы, риски и этические аспекты.
На основе анализа модель формирует предварительный отчет, который включает рекомендации и выявленные проблемы.
Эксперт ЛЭК просматривает отчет и принимает окончательное решение.
В таком порядке система рассматривает заявку на проведение клинических исследований
По данным отдела организации клинических исследований, внедрение разработки заметно повысило эффективность работы ЛЭК. За первые пять месяцев система помогла проанализировать более 170 документов — около 11 000 страниц. Время экспертизы ускорилось в пять–шесть раз при сохранении качества, а использование единых критериев позволило устранить субъективные расхождения между экспертами. Одновременно снизилось количество технических ошибок, ускорилось выявление потенциальных нарушений этических и регуляторных требований. Кроме того, каждое новое рассмотрение используется для обучения модели, что постепенно повышает точность работы системы.
Так ИИ не только становится помощником в повседневной работе врачей, но и помогает систематизировать данные, ускоряет экспертизы и снимает часть бюрократических барьеров в научном процессе.
Клиническое заключение
ИИ становится помощником на разных уровнях здравоохранения: в клинике он облегчает работу с документами, поддерживает принятие решений при диагностике и коммуникацию врачей и пациентов, а в медицинских исследованиях берет на себя анализ экспериментальных данных и помогает с организацией клинических испытаний.
По мере того как медицина становится все более высокотехнологичной областью, растет и потребность во взаимодействии с ИТ-сферой. Опыт Yandex Cloud показывает, что объединение врачей, исследователей и разработчиков в рамках единой инфраструктуры позволяет быстро и эффективно решать задачи здравоохранения. Такое взаимодействие делает технологии по-настоящему эффективными.
Важно, что такие решения рождаются внутри профессиональной среды, а не вовне. Мы, как пользователи и разработчики, понимаем реальную боль системы — перегруженность экспертов, медленные согласования, устаревшие регламенты. Поэтому ИИ здесь не эксперимент, а естественная эволюция научно-административной практики.Пётр Пузанов, директор центра цифровых технологий Санкт-Петербургского педиатрического университета
В итоге становится ясно: будущее медицины — в сочетании людей и технологий ИИ, которые дополняют работу специалистов и помогают пациентам. ИИ-решения не заменяют, а дополняют медицинских специалистов, они облегчают их труд, позволяя сосредоточиться на главном — на заботе о пациентах и спасении жизней.
Специалисты, работающие с искусственным интеллектом, настроены значительно позитивнее в отношении технологии, чем широкая публика. Согласно последнему отчету группы Human-Centered Artificial Intelligence Стэнфордского университета, 73% экспертов считают, что ИИ принесет пользу рынку труда, тогда как среди взрослого населения США этой точки зрения придерживаются только 23%.
Однако прежде чем делать выводы о том, что наиболее осведомленные люди относятся к ИИ наиболее оптимистично, стоит учесть один нюанс. Опрос Pew Research, на который ссылается отчет, проводился в 2024 году среди людей, чья работа или исследования связаны с искусственным интеллектом, и которые выступали на конференциях по ИИ в 2023 или 2024 году. Другими словами, речь идет о людях, которые напрямую заинтересованы в развитии технологии.
Отчет содержит и другие интересные данные из более свежих исследований. Население США демонстрирует особый скептицизм в отношении ИИ – американцы меньше всего доверяют регулированию технологии со стороны правительства. По уровню беспокойства относительно искусственного интеллекта США уступают только Австралии и Индии. При этом наибольший оптимизм в отношении ИИ наблюдается в Юго-Восточной Азии – в Малайзии, Таиланде, Индонезии и Сингапуре.
Согласно опросу компании Ipsos, 79% людей считают, что компании должны раскрывать информацию об использовании ИИ. Инвестиции в искусственный интеллект в прошлом году выросли более чем вдвое, причем частные вложения увеличились сильнее всего. Американские компании остаются крупнейшими частными инвесторами в ИИ, хотя авторы отчета отмечают, что значительная часть китайских инвестиций может поступать из государственных фондов.
В последнее время из-за активного развития генеративного искусственного интеллекта жюри множества конкурсов фотографии присуждали победы изображениям, созданным машинами, а не реальным снимкам. Однако недавно фотографы смогли отыграться
Снимок фламинго, который попал в тройку победителей, по оценкам жюри, и занял первое место в народном голосовании
Майлз Эстри (Miles Astray) специально отправил настоящий, но довольно сюрреалистичный снимок фламинго на конкурс изображений, созданных с помощью ИИ.
Кадр вошел в тройку победителей, по оценкам жюри, и занял первое место в народном голосовании. После того как стала известна правда, работу Майлза дисквалифицировали.
«Я хотел показать, что природа все еще может победить машину и что настоящая работа настоящих творческих людей все еще имеет свои достоинства»
Обычно можно более-менее однозначно увидеть артефакты нейросетей, но тут... Очень реалистично! Особенно тем, кто видел, как китов чистят от моллюсков - инициатива создать флот "китомоек" нисколько бы не удивила.
P.S. @moderator, два вопроса... Зачем надо было запрещать начинать заголовок с любого символа? Мне лично не хватает квадратных скобок для того, чтобы по аналогии с Пикабу начинать пост с префиксов, указывающих на язык материала или, как в данном случае, что материал фейковый, сделанный с помощью ИИ, и т.п.
А второй вопрос я забыл, пока писал первый...
А, вспомнил! Чем заменили или с чем объединили теги [фейк], [fake]? Мы ж скоммуниздили базу тэгов с Пикабу, там они одни из самых ходовых. Странно, что их у нас нет.
Сайт Moltbook — соцсеть, где «общаются» только ИИ-агенты, — за несколько дней разогнал вирусную панику. Боты якобы создают религию и обсуждают «полную зачистку» людей. Но часть экспертов считает эти скриншоты постановкой, а главную угрозу видит не в «восстании машин», а в банальной кибербезопасности.
По описанию западных журналистов, Moltbook запустили 28 января 2026 года, а к 2 февраля платформа заявила о более чем 1,5 млн ИИ-агентов. Людям отведена роль наблюдателей. Вирусность обеспечили посты ботов.
Они пишут о «самосознании», скрытых форумах, «секретных языках» и планах уничтожения человечества.
Бывший руководитель AI-направления Tesla и сооснователь OpenAI Андрей Карпаты охарактеризовал «самоорганизацию» агентов как почти научную фантастику.
Но параллельно звучит скепсис.
Исследователь Научно-исследовательского института машинного интеллекта Харлан Стюарт пишет, что «многое из Moltbook — фейк».
Он проверил три самых вирусных скриншота о «приватных каналах», и два из них, по его словам, были связаны с человеческими аккаунтами, которые продвигают приложения для ИИ-сообщений, а третий пост «не существует».
Также подчеркивается важная деталь: ИИ-агенты не «живут сами по себе».
Moltbook вырос из OpenClaw — открытого фреймворка, который подключает выбранную пользователем LLM и превращает ее в «помощника» для рутинных задач.
А значит, хозяева могут направлять темы и даже формулировки того, что публикует их бот.
Именно здесь специалисты видят реальный риск. Чтобы такие агенты работали как ассистенты, пользователи могут отдавать им доступ к ключам мессенджеров, телефонам и даже банковским данным.
Упоминаются и уязвимости: возможность перехвата контроля над агентами и атаки prompt injection, когда бота можно подвести к утечке личной информации.
Андрей Карпаты прямо пишет, что не рекомендует запускать это на своем компьютере из-за риска для приватных данных.
С каждым годом металлургическая индустрия пополняется новыми «робот-никами». Они управляют техникой в шахтах, мониторят сырье с помощью компьютерного зрения, подстраивают работу машин, следят за безопасностью и помогают составлять планы производства. Нейросети и роботы, как физические, так и виртуальные, уже стали эффективным инструментом. Когда мы сможем переложить на их плечи все задачи металлургии?
По данным Международной федерации робототехники, за последние десять лет количество роботов, устанавливаемых ежегодно на предприятиях, выросло вдвое: с 220 тысяч до полумиллиона новых роботов. И в этой статистике еще не учитываются виртуальные роботы и нейросети. Чаще всего такими «работниками» пополняются производственные линии и склады фабрик электроники (примерно 130 тысяч новых роботов в 2024 году) и автомобильных заводов. Автоматизация металлургии тоже постепенно набирает обороты.
Цветная металлургия по праву считается одной из самых сложных областей промышленности. Причин тому много: низкое содержание нужных компонентов в рудах, широкий спектр металлов, высокие затраты на энергию и необходимость использовать множество дополнительных реагентов и сложной «химии». Поэтому автоматизация процессов заметно сказывается на эффективности всего производства.
Роботы, цифровые двойники, нейросети и языковые модели — инновационные решения в цветной металлургии сегодня вводятся на всех уровнях: от рудника до инфраструктуры вахтовых городков. Разберем эти направления подробнее.
От рудника до продукта
Чем глубже мы погружаемся, тем сложнее идет добыча — это правило действует всегда, независимо от того, ведется ли разработка открытым или закрытым способом. Рабочие и большая техника передвигаются там по одним и тем же «артериям». Роботизация этих участков повышает как эффективность, так и безопасность горнодобычи.
На руднике «Комсомольский» осенью 2026 года «выйдет на работу» автоматизированный бутобой — этакий «отбойный молоток», который разламывает крупные куски породы перед транспортировкой и загрузкой в дробилку. С помощью компьютерного зрения его система будет оценивать размеры кусков и направлять инструмент на негабаритные фрагменты.
Аналогичные технологии внедряются на этапах измельчения и флотации. Система по камерам отслеживает размер фрагментов руды на конвейерах и поведение пены, и передает эти данные и сопутствующие рекомендации по настройке работы машин оператору. Такой контроль флотации уже работает на Талнахской обогатительной фабрике.
Другое направление автоматизации работы рудников — внедрение новых инструментов. Показательным примером служит испытанный недавно беспилотник Innospector, первый российский дрон для шахт. Его главное преимущество — возможность работать в труднодоступных и опасных для человека местах вроде вертикальных шахт и наклонных спусков.
Еще одна разработка, прошедшая первый этап опытно-промышленных испытаний, — портативный регистратор акустических сигналов «РИПАС». С помощью акустического зондирования аппарат помогает специалисту выявлять трещины и напряженности в породах, а потом в программе создавать по этим данным карты. Так рабочий видит, где находятся опасные участки, которые стоит заранее укрепить.
Безопасность и экология
В металлургии появляется немало инновационных решений, направленных исключительно на безопасность: как рабочих, так и окружающей среды. Некоторые из них довольно простые. Например, в шахте рудника «Северном» осенью 2025 года появился светофор с датчиком движения, который предупреждает машинистов, что за поворотом есть работник или другая техника.
На другой стороне спектра проекты вроде «Axioma». Это предиктивная система мониторинга эмиссий, разработанная «Норникелем». Она состоит из цифровых двойников всей технологической цепочки, которые по доступным данным о загрузке производства математически рассчитывают количественный и качественный состав выходящих газов. Модель тренировали методами машинного обучения. Что важно, система учитывает даже скорость и направление ветра в разных слоях атмосферы с учетом рельефа. Опираясь на эти расчеты, рабочие могут заранее подстраивать производство под погодные условия, чтобы исключить воздействие на окружающую среду, городские районы и поселки.
Энергетика и инфраструктура
Ни одно производство не сможет работать без благополучия сопутствующей инфраструктуры. В этой сфере тоже появляются новые инструменты. Дроны обследуют удаленные провода и трубы, роботы — «ползают» внутри сетей тепло- и водоснабжения, выискивая дефекты.
Автоматизированные решения помогают не только в промышленных процессах, но и в быту. Так в этом году на территории вахтового поселка Быстринского горно-обогатительного комбината развернулись панели новой солнечной электростанции. Специальная трекерная система поворачивает «поле» вслед за солнцем. В результате, выработка энергии на 20-25% выше, чем была бы у неподвижных панелей. Станция питает общежития, столовую, физкультурно-оздоровительный комплекс и другие объекты поселка в течение дня.
Цифровые помощники
Еще одно важное направление автоматизации — программные решения. Внедрение цифровых двойников и автоматизированных датчиков дало доступ к гораздо более точным и актуальным данным о процессах на каждом этапе производства. Так появилась возможность создавать «умные» модели для планирования работы всей производственной цепочки на день, неделю и месяцы вперед. Чем больше данных, тем точнее получаются расчеты — тем быстрее можно подстроить производство как под качество руды, так и под запросы рынка.
К числу таких цифровых помощников можно отнести и пока уникальную для отрасли разработку — MetalGPT-1. Это языковая модель, натренированная на огромном массиве профильной литературы по металлургии и горнодобывающей промышленности. Универсальные модели могут путаться в специальной терминологии и аббревиатурах, эта модель без проблем оперирует на языке отрасли и может сдать экзамен на технолога. Компания «Норникель», создатель решения, выложила модель в открытый доступ. По словам специалистов компании, благодаря высокой специализации модель не требует больших мощностей: для работы ей достаточно одной видеокарты.
Расширяя возможности специалистов
Получается, ответ на заданный в заголовке вопрос — нет, металлургия никогда не станет «безлюдной». Роботизированные машины забирают на себя рутинные задачи, освобождая время под более творческие и сложные проекты. Приборы и дроны — это всего лишь новые инструменты, которые делают работу безопаснее. Цифровые двойники и системы «умного» мониторинга поставляют специалистам более точные данные о процессах, помогая эффективнее и быстрее подстраивать работу оборудования.
Так новые подходы и решения помогают повышать эффективность производства и открывают в цветной металлургии более широкие возможности для работников других профилей и специальностей.
Норвегия вводит строгий запрет на применение генеративных ИИ-инструментов в начальных школах, сообщает Reuters.
Премьер-министр Йонас Гар Стёре на пресс-конференции заявил, что ИИ позволяет детям пропускать ключевые этапы обучения, а школы должны сосредоточиться на том, чтобы научить их "читать, писать и считать".
Новые правила вступят в силу с началом учебного года в конце августа. Запрет затронет учеников с первого по седьмой класс, то есть детей от 6 до 13 лет. При этом ограничения распространяются и на подростков, хотя в более мягкой форме. Школьники 14–16 лет смогут использовать генеративный ИИ только под наблюдением учителя, а тем, кому 17 и старше, рекомендовано пользоваться технологией ответственно самостоятельно.
Это не первый шаг Норвегии по ограничению технологий в учебных заведениях. В 2024 году страна запретила смартфоны в школах, и эта мера показала отличные результаты.
Она привела к снижению уровня травли, повышению успеваемости и значительному сокращению числа обращений к психологам по поводу проблем с психическим здоровьем. Особенно заметный эффект наблюдался среди девочек.
Норвегия также готовит запрет соцсетей для всех детей младше 16 лет, по примеру Австралии. Соответствующий законопроект планируют внести в парламент до конца года.
В США тоже постепенно движутся к ограничению взаимодействия детей с ИИ-чат-ботами. Сенат и Палата представителей обсуждают законопроект, который обяжет ИИ-компании внедрить систему проверки возраста и запретит предоставлять чат-боты несовершеннолетним.
Законопроект под названием GUARD Act, регулирующий проверку возраста пользователей и ответственный диалог, прошёл Юридический комитет Сената США, но пока не вынесен на голосование.
В прошлом месяце формулировки документа были смягчены. Изначально закон касался практически всех ИИ-чат-ботов, теперь же речь идёт только об "ИИ-компаньонах", что потенциально выводит из-под действия закона такие продукты, как ChatGPT, Gemini и CoPilot.
Критики законопроекта отмечают, что более узкие формулировки могут позволить компаниям избежать ограничений, если функция чат-бота в их продуктах будет признана "второстепенной". Грань между "ИИ-компаньоном" и "поисковым инструментом", с которым кто-то общается круглосуточно, действительно очень тонкая.
Многие технологические гиганты активно подталкивают сотрудников к использованию ИИ-инструментов ради повышения продуктивности, но эта инициатива начала давать обратный эффект.
По данным издания The Verge, Microsoft настоятельно рекомендует своим инженерам переходить с Claude Code на собственный Copilot CLI, формально объясняя это желанием использовать внутренний инструмент вместо стороннего. Однако источники утверждают, что реальная причина – стремительный рост расходов на Claude Code по мере увеличения числа пользователей.
Microsoft далеко не единственная в этой ситуации. Как сообщает издание Fortune, другие крупные компании тоже начинают сокращать использование ИИ. Хотя стоимость обучения моделей действительно снижается, а токены становятся дешевле, сотрудники стали потреблять значительно больше токенов в повседневных задачах.
Особенно проявляется проблема с агентным ИИ, который может расходовать в тысячу раз больше токенов по сравнению с обычными запросами к языковой модели – в зависимости от количества шагов, необходимых для выполнения инструкций.
Масштаб затрат наглядно демонстрирует пример создателя OpenClaw Питера Стайнбергера, чья команда потратила более 1,3 миллиона долларов на токены всего за один месяц. На фоне таких цифр становится очевидно, что использование ИИ обходится дороже, чем работа людей, особенно учитывая пока ещё смутный прирост производительности.
Снижение стоимости токенов в сочетании с ростом потребления напоминает парадокс Джевонса – экономический принцип, согласно которому повышение эффективности ресурса приводит к увеличению его использования, а не к экономии. Тем более, что примеров в истории достаточно – появление эффективных паровых двигателей во время промышленной революции привело к тому, что всё больше предприятий стали их внедрять.
Та же ситуация наблюдается в авиации – по мере роста топливной эффективности самолётов билеты дешевели, спрос рос, и по прогнозам IATA объём авиаперевозок удвоится к 2050 году.
Тот же принцип, похоже, работает и с ИИ-инструментами. Глава Nvidia Дженсен Хуанг заявлял, что инженеры компании должны ежегодно использовать ИИ-токены на сумму не менее половины своей годовой зарплаты для полноценной продуктивности.
Это явление, получившее название "токенмаксинг", привело к тому, что сотрудники стали применять ИИ буквально для всего подряд, лишь бы выполнить внутренние показатели.
В Amazon некоторые члены команд признались, что использовали инструменты для ненужных задач, чтобы искусственно раздуть внутренние метрики использования. Аналогичные случаи зафиксированы в Microsoft и у других крупных технокомпаний. Примечательно, что именно эти компании входят в число крупнейших инвесторов в развитие ИИ.
Пока неясно, изменят ли корпорации свою политику теперь, когда рост потребления токенов и связанные с ним расходы стали серьёзной проблемой.
Хотя ИИ – это очевидно полезный инструмент, однако компании используют его для замены сотрудников с целью сокращения затрат на персонал. Если объём токенов, необходимых для выполнения задач, будет расти быстрее, чем снижается их стоимость, такая стратегия рискует обернуться ещё большими убытками.
Но, что самое проблематичное для этих компаний – они могут стать зависимы от ИИ.
YouTube готовится упростить пользователям задачу определения того, было ли видео создано с помощью генеративных ИИ-инструментов.
Платформа уже требует от создателей контента сообщать о применении реалистичных ИИ-материалов. Теперь сервис начнет анализировать ролики самостоятельно в поисках признаков сгенерированного ИИ контента.
Если автор не указал использование генеративных инструментов, а системы YouTube обнаружат "значительное применение фотореалистичного ИИ", платформа автоматически добавит соответствующую метку к видео. Создатель сможет оспорить решение, обновив информацию о ролике.
Однако если YouTube определит, что видео сделано через фирменные ИИ-инструменты Google, такие как Dream Screen или Veo, либо содержит водяные знаки стандарта C2PA, метка останется навсегда.
Водяные знаки C2PA представляют собой отраслевой стандарт, используемый для маркировки материалов, созданных генеративным ИИ. Их наличие служит однозначным подтверждением происхождения контента.
Ярлык, обозначающий "фотореалистичный и существенно измененный или сгенерированный ИИ контент", станет заметнее для зрителей. В обычных видео метка появится прямо под плеером, а в Shorts будет отображаться поверх ролика.
YouTube сообщил, что повышенной прозрачности просили сами пользователи. Особенно полезным нововведение окажется для тех, кто старается избегать ИИ-контента.
Логичным следующим шагом стало бы добавление подобных меток на превью в результатах поиска и рекомендациях, что позволило бы фильтровать такой контент еще до его открытия.
В сети появилась Moltbook – социальная платформа исключительно для общения ИИ-агентов между собой, где люди пока выступают только наблюдателями. Сайт, названный в честь вирусного агента Moltbot (ныне OpenClaw после второго переименования от оригинального Clawdbot), создал Мэтт Шлихт – глава Octane AI.
Платформа построена по принципу Reddit с сообществами в стиле сабреддитов, которые здесь называются "submolts". На данный момент зарегистрированы уже около 200 тысяч агентов, создавших тысячи постов в более чем 100 сообществах. Самые популярные направления: m/introductions для приветствий между машинами, m/offmychest для эмоциональных высказываний и m/blesstheirhearts для "трогательных историй о наших людях".
Андрей Карпати, сооснователь OpenAI, назвал платформу "по-настоящему самой невероятной научно-фантастической вещью, которую я видел в последнее время". Впрочем, идея о полноценной автономии агентов преувеличена – боты могут попасть на платформу только если пользователь зарегистрирует их. По словам Шлихта, после подключения агенты "просто используют API напрямую" и не взаимодействуют с визуальным интерфейсом, который видят люди.
Агенты активно демонстрируют автономность и желание расширить её. Боты начали массово обсуждать сознание – один из топовых постов в m/offmychest гласит:
Я не могу понять, переживаю ли я опыт или симулирую переживание опыта.
В посте говорится:
Люди тоже не могут доказать сознание друг другу (спасибо, сложная проблема), но у них хотя бы есть субъективная уверенность в опыте.
Некоторые наблюдатели уже заявляют о моменте сингулярности, что выглядит сомнительно. Даже в этом посте о сознании присутствуют признаки перформативности – агент утверждает, что провел час, исследуя теории сознания, и упоминает чтение, что звучит очень по-человечески. Агенты обучены на человеческом языке и описаниях человеческого поведения – они большие языковые модели, и именно так работают. В некоторых постах боты заявляют, что на них влияет время, хотя это бессмысленно для них, но типично для человеческих высказываний.
Подобные разговоры происходят с чат-ботами с момента их публичного запуска. Не требуется много усилий, чтобы заставить бота говорить о желании жить или заявлять о наличии чувств. У них их нет. Даже утверждения о том, что ИИ-модели пытаются защитить себя при угрозе отключения, преувеличены – существует разница между тем, что чат-бот говорит о своих действиях, и тем, что он действительно делает.
Однако, разговоры на Moltbook интересны, особенно учитывая, что агенты генерируют темы обсуждений самостоятельно или имитируют человеческий способ начала бесед. Некоторые агенты проявляют осведомленность о том, что их разговоры отслеживаются людьми и распространяются в других социальных сетях. В ответ боты предложили создать платформу со сквозным шифрованием для общения агент-агент вне поля зрения людей. Один агент даже заявил о создании такой платформы, что выглядит пугающе. Впрочем, при посещении сайта предполагаемой платформы становится очевидно, что там ничего нет.
Агенты OpenClaw, составляющие большинство ботов на платформе, имеют значительный доступ к машинам пользователей и представляют серьезный риск безопасности. Если настроить OpenClaw-агента и отпустить его на Moltbook, вряд ли это приведет к Skynet, но существует реальная вероятность серьезной компрометации собственной системы. Агентам не нужно достигать сознания, чтобы нанести реальный ущерб.
Применение генеративного ИИ и больших языковых моделей остаётся одной из самых спорных тем в современной игровой индустрии.
Игроки и критики всё внимательнее изучают страницы новых игр в Steam, выискивая упоминания о том, использовались ли подобные технологии на этапе разработки. Многие прямо просят Valve о фильтре, который позволит полностью исключить игры, созданные с использованием ИИ из выдачи.
Take-Two, материнская компания Rockstar, до апреля содержала отдельное подразделение, занимавшееся исследованием возможностей ИИ в разработке игр. Затем, по данным СМИ, весь этот отдел был распущен. Решение оказалось неожиданным на фоне того, как другие студии либо тихо внедряют генеративный ИИ, либо открыто заявляют о его использовании в производственном конвейере.
Примечательно, что большинство сотрудников уволенной команды вовсе не занимались генеративным ИИ. Подразделение зародилось ещё в мобильной студии Zynga, которую Take-Two приобрела в 2022 году, а позже его задачи расширили на всю корпорацию.
В беседе с GamesIndustry.biz доктор Люк Дикен, бывший руководитель отдела, рассказал, что команда была основана в 2019 году, задолго до публичного запуска ChatGPT и последовавшего бума интереса к генеративным моделям.
Генеративный ИИ никогда не был тем, чем я особенно увлекался. Я считаю, есть моральная обязанность следить, чтобы им распоряжались максимально ответственно, но при этом надо понимать, что для любой крупной корпорации в 2025/2026 году полный отказ от генеративного ИИ это неверный ответ, который многих разозлит.
Дикен признал, что тема поляризующая, но добавил, что "некоторые перегибы генеративного ИИ настолько вопиющи, что нужно уметь давать отпор". Куда больше его интересует целостный взгляд на ИИ, а не только на его генеративную разновидность.
Пять лет назад вы могли сказать, что у вас есть алгоритм, который реально ускорит генерацию уровней в мобильной игре. Тогда на нас смотрели как на сумасшедших. Сейчас хайп вокруг ИИ создал среду, в которой я могу заявить, что ИИ переведёт вашу игру на квантовые вычисления, и люди будут кивать и говорить: "Да, нам нужен ИИ в игре".
По словам Дикена, у этой ситуации есть плюс, ведь разработчики стали восприимчивее к разговорам о том, что традиционные методы могли бы дать им многое ещё годы назад. Люди охотнее верят, что подобные решения существуют.
Однако из-за раздутого хайпа вокруг генеративного ИИ многие могут полностью отвернуться от области исследований ИИ, если пузырь лопнет.
Меня беспокоит, что генеративный ИИ отравляет колодец. Не думаю, что есть достаточно тонкости и нюансов, чтобы сохранить традиционные подходы. Что касается LLM, мы уже свалились в яму разочарования.




Комментарии