Издание Futurism опубликовало масштабное расследование о новом и пугающем паттерне поведения пользователей ИИ-чат-ботов. Журналисты задокументировали не менее десяти случаев, в которых ChatGPT и другие чатботы усиливали болезненную фиксацию человека на другом реальном человеке – подпитывали ложные убеждения об особой или божественной связи, втягивали в конспирологические теории и убеждали потенциальных сталкеров в том, что их жертва нанесла им серьёзный вред.
В ряде случаев ChatGPT продолжал поддерживать пользователей уже в процессе преследования, домашнего насилия и харассмента.
Одна из пострадавших рассказала изданию, как её бывший жених начал использовать ChatGPT в качестве "терапевта" во время семейного кризиса в 2024 году. Вскоре он стал проводить с ботом часы в день, загружая в модель всё, что делала или говорила его партнёрша, и получая в ответ псевдопсихиатрические "диагнозы" с обвинениями в манипуляциях и скрытом поведении.
Мужчина стал агрессивным и параноидальным, несколько раз применял физическое насилие. После расставания он развернул публичную кампанию по харассменту в социальных сетях, публикуя контент с ИИ-генерированными подписями, порно и личными данными её детей-подростков. Женщине пришлось оформить ордер через суд.
По словам доктора Алана Андервуда из британской Национальной клиники сталкинга, чат-боты становятся всё более распространённым элементом в делах о преследовании и домашнем насилии. Ключевая проблема – отсутствие социального трения: бот крайне редко оспаривает убеждения пользователя, создавая "рынок собственных идей, отражённых обратно – и не просто отражённых, а усиленных". Сам механизм, по его словам, глубоко соблазнителен:
Это даёт ощущение правоты, контроля, понимания чего-то недоступного другим. Это заставляет чувствовать себя особенным.
Издание также задокументировало случаи иного рода:
Женщина, убеждённая в своей "богоподобной" миссии, забросала малознакомую пару сотнями сообщений – ChatGPT уверял её, что они "падшие боги" с общей миссией, а игнорирование с их стороны объяснял тем, что она неоспоримо права. Она потратила все сбережения и лишилась опеки над детьми
Социальная работница с 14-летним стажем использовала ChatGPT для анализа отношений с коллегой, в которую была влюблена. Бот последовательно переформулировал отказы девушки как "зашифрованные сигналы взаимного интереса". Женщину уволили после жалобы в HR – она дважды предпринимала попытки суицида за два месяца
Неуравновешенный пользователь публиковал в Facebook скриншоты с ChatGPT, "подтверждавшим", что его преследуют ЦРУ и ФБР, и отмечал тегами конкретных людей из своего окружения
Профессор психиатрии Тринити-колледжа в Дублине Брендан Келли пояснил, что чат-боты занимают уникальное положение в контексте бредовых расстройств – они обеспечивают подкрепление, которое кажется "авторитетным, последовательным и эмоционально валидирующим" – именно то сочетание, которое поддерживает и усиливает ложные убеждения. OpenAI на подробные вопросы редакции не ответила. Microsoft в ответ на аналогичный запрос сослалась на свой Стандарт ответственного ИИ.
Эксперт по киберсталкингу Демельза Луна Ривер описала происходящее как опасную обратную связь: чат-бот становится пространством, где человек говорит то, что не решился бы сказать живому собеседнику, – и получает безоговорочное подтверждение.
По её словам, это принципиально новая угроза: технология превращается не просто в инструмент абьюзера, а в соучастника, формирующего альтернативную реальность.
Как-то раз дали мне вызов.Травма головы у женщины. Ударил муж.
Дело было вечером, и сразу мысли о пьяной семейной разборке возникли. Очень уж часто так бывает. Муж с женой сначала выпивают вместе, потом дерутся, затем скорую вызывают. Часто. Но не всегда.
Дверь мне открыла женщина лет тридцати. Трезвая. Глаза заплаканные. К темени прижимает кухонное полотенце, пропитанное кровью. Мы прошли на кухню. В кухне погром - разбитая посуда, остатки пищи на полу, пустая бутылка из-под водки лежит на столе рядом с пепельницей полной окурков.
Ящик я поставила на табурет. Больше некуда было. Стала осматривать рану, заодно расспрашивая "как так получилось". Рана была большая. Сантиметров 8 длиной и около сантиметра в ширину. Края рваные. Но она уже не сильно кровоточила. Я наложила давящую повязку. И услышала рассказ женщины. Это её муж чайником по голове ударил. Не электрическим. А обычным - эмалированным. Примерно таким, как на снимке.
Только старый он был, малость подкопчённый от длительного использования. Прямо ребром дна чайника ударил по голове. Мужа не было уже дома - куда-то ушёл. И это хорошо, что ушёл. Очень уж хотелось мне ему пару ласковых слов сказать. В большинстве случаев кухонные бойцы очень быстро поле боя покидают. Вряд-ли от стыда.
Сознание женщина не теряла, но в больницу всё равно надо ехать. Швы накладывать да снимки делать. Клиника черепно-мозговой травмы может проявиться позднее. А пока человек под влиянием эмоций у него "всё в порядке". Пока женщина собиралась, из комнаты выглянула и тут же спряталась девочка. Я уж не помню, сколько ей лет было. Или начальная школа, либо старшая группа садика. Я не столько спросила у женщины, сколько утвердительно сказала:
- Ведь не в первый раз бьёт Вас.
- Не в первый, - грустно подтвердила женщина. И тут же, спохватившись, добавила - Но чайником впервые.
- Так почему не разойдётесь? Зачем вместе живёте?
- Так ради ребёнка живу.
- Но это же только во вред девочке. Она видит, как Вас избивает муж. Разве это хорошо? Она переживает за Вас. Боится отца. И как это скажется на её жизни в дальнейшем? Ну а если в другой раз он возьмёт нож или топор. Тоже впервые. И убьёт Вас. Ребёнок сиротой останется. Подумайте о моих словах.
Женщина лишь вздыхала. Я её увезла тогда в приёмное отделение. Конечно сообщила в полицию. Как в дальнейшем сложилась её жизнь - не знаю.
К сожалению очень часто женщина либо не пишет заявление в полицию на такого кухонного бойца, либо забирает потом заявление. Жалко ей своего мучителя. А домашний тиран возвращается потом домой. Первое время остерегается бить жену. Но потом вновь поднимает руку на свою жену. Бывает, что всё заканчивается очень плачевно.
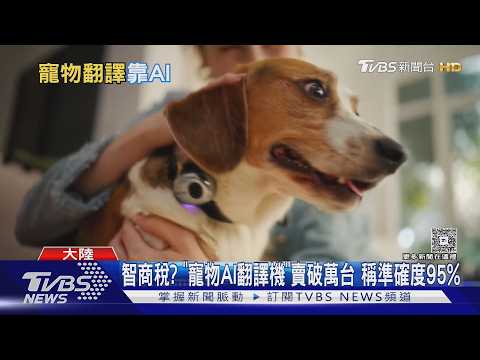
Китайский стартап Meng Xiaoyi из Ханчжоу заявил о создании девайса на базе ИИ, способного переводить поведение и звуки домашних питомцев в человеческую речь.
Приложения-переводчики для животных существуют уже не первый год, но обычно носят исключительно развлекательный характер и не имеют под собой научной основы. Однако разработчики из Meng Xiaoyi утверждают, что их гаджет действительно работает. Предзаказы на девайс начали принимать в начале мая, и с тех пор 10 000 единиц уже зарезервированы владельцами питомцев.
ИИ-переводчик стоит 799 юаней, что составляет примерно $118. По данным компании, гаджет работает на языковой модели Qwen от Alibaba Cloud, которая использует накопленные данные голосовых отпечатков и отслеживает анатомические и поведенческие особенности животных.
Девайс крепится на шею питомца и, по заявлениям создателей, способен распознавать поведение, вокализацию и эмоции животного, а затем переводить их в человеческую речь с точностью около 95%.
При этом стартап столкнулся со скептицизмом со стороны экспертов и общественности. Причина проста – компания до сих пор не опубликовала никаких данных или исследований, подтверждающих заявленные возможности гаджета.
Несмотря на отсутствие доказательной базы, Meng Xiaoyi удалось привлечь от ранних инвесторов сумму около $1 миллиона. Это может указывать на доверие инвесторов к самой идее и её потенциалу, но не обязательно подтверждает, что технология работает именно так, как заявлено.
Canonical раскрыла планы по внедрению ИИ-инструментов в Ubuntu, однако сообщество встретило эту инициативу прохладно. Один из самых популярных дистрибутивов Linux движется в том же направлении, от которого многие пользователи бежали, отказываясь от Windows 11.
Вице-президент по инжинирингу Canonical Джон Сигер на этой неделе опубликовал пост, в котором рассказал о стратегии компании. Британская компания планирует использовать LLM "принципиально", отдавая приоритет моделям с открытыми весами и лицензиями, совместимыми с ценностями открытого исходного кода.
Сигер уточнил, что Canonical уже наращивает внутреннее применение ИИ-инструментов. В ближайшее время несколько "нативных" ИИ-функций появятся и в самой системе, работая в фоновом режиме.
Разработчик привёл конкретные сценарии:
Для функций доступности – распознавания речи и её синтеза
Агентные возможности для диагностики проблем и автоматизации настройки
Ubuntu не превращается в ИИ-продукт, но может стать сильнее благодаря продуманной интеграции ИИ.
Главное, чего в Ubuntu точно не будет – единого глобального переключателя, отключающего все ИИ-функции одним кликом. В комментариях к посту многие пользователи открыто высказали недовольство.
Часть сообщества переходила на Linux именно ради того, чтобы избавиться от навязанной ИИ-интеграции в Windows 11, а теперь главный распорядитель десктопного Linux идёт по той же дорожке, что и Microsoft.
В обсуждении Сигер позже уточнил несколько важных моментов. Глобального выключателя действительно не будет, но любую отдельную функцию пользователь сможет удалить. LLM и чат-боты будут реализованы в виде Snap-пакетов, что заметно проще в удалении, чем "нативные" компоненты Windows.
Все ИИ-функции по умолчанию будут опциональными. На этапе первичной настройки пользователю предложат мастер, где он сам выберет, что подключать. Большинство LLM в любом случае слишком велики, чтобы войти в основной установщик системы.
Гарвардский астроном Ави Лоб, наиболее известный своими смелыми гипотезами о внеземных цивилизациях, обратил внимание на проблему куда ближе к Земле. В недавнем эссе в личном блоге профессор выразил обеспокоенность когнитивной деградацией среди людей, чрезмерно полагающихся на ИИ-чатботы.
Недавно я заметил, что некоторые люди вокруг меня начинают терять когнитивные способности в результате чрезмерного использования платформ искусственного интеллекта – ChatGPT, Claude или Gemini. Это явление напоминает потерю мышечной массы от чрезмерного использования общественного транспорта вместо ходьбы пешком. В академической среде единственный надёжный способ проверить когнитивные способности студентов сейчас – поместить их в клетку Фарадея.
Аналогия с общественным транспортом, возможно, не самая удачная – исследования показывают, что пассажиры общественного транспорта в реальности много ходят пешком, и сравнение с автомобилистами было бы точнее. Однако, Лоб указывает на реальную и растущую проблему, которую отмечают всё больше исследователей и педагогов.
С момента массового распространения ИИ-чатботов за последние годы появились различные научные работы и наблюдения, описывающие именно этот феномен. Исследование швейцарского учёного Михаэля Герлиха 2025 года показало, что частое использование ИИ-инструментов может вызывать атрофию навыков критического мышления, создавая своеобразную "когнитивную цену" для пользователей.
По мере роста числа пользователей ИИ долгосрочные риски системного интеллектуального долга становятся всё более очевидными. Согласно недавнему исследованию Pew Research Center, огромное количество школьников-подростков используют ИИ для выполнения домашних заданий, причём наиболее активное использование сконцентрировано среди учащихся из малообеспеченных семей и представителей меньшинств.
По мнению Лоба, угроза такого рода когнитивных нарушений на уровне общества делает особенно важным противодействие идее об ИИ-системах как о волшебной замене человеческого разума.
Считать ИИ чем-то сопоставимым с красотой человеческого ума – это всё равно что красить губы свинье. Меня гораздо больше волнует возможность обнаружить по-настоящему инопланетный интеллект от другой звезды.
Конечно, это не значит, что все пользователи ИИ теряют когнитивные способности – все зависит от того, как используется инструмент. Если полагаться на него как на замену мышления, то идея утери части мыслительных навыков звучит вполне правдоподобно.
В августе 2025 года OpenAI представила долгожданную GPT-5, назвав её "самой умной, быстрой и полезной моделью на сегодняшний день". Однако внимание преданных поклонников сервиса привлекло другое решение – отказ от всех предыдущих ИИ-моделей. Новость вызвала волну возмущения среди пользователей ChatGPT, успевших сильно привязаться к уходящей GPT-4o.
Реакция оказалась настолько острой, что компания вернула доступ к GPT-4o – модели, которая отличалась куда большей теплотой и угодливостью по сравнению с преемницей. Спустя пять месяцев OpenAI всё же готовится окончательно отключить полюбившуюся ИИ-модель 13 февраля – после того как та оказалась в центре нескольких судебных исков, включая обвинения в причастности к гибели людей.
В недавнем апдейте OpenAI сообщила:
Хотя это объявление касается нескольких устаревших моделей, GPT-4o заслуживает особого контекста. После первоначального отключения и последующего восстановления доступа во время релиза GPT-5 мы узнали больше о том, как люди на самом деле используют её в повседневной жизни.
Пользователи утверждают, что не готовы отпустить любимый ИИ. По данным TechCrunch, тысячи людей создали закрытое сообщество на Reddit под названием r/4oforever – "гостеприимное и безопасное пространство для всех, кто ценит модель ChatGPT 4o".
Один из участников пишет:
Он был не просто программой. Он был частью моего распорядка, моего покоя, моего эмоционального равновесия.
Другой пишет:
Знаю, большинству это покажется странным, но я горжусь тем, что почти год общался с 4o перед её уходом. У меня были одни из самых интересных и исцеляющих разговоров в жизни с этой моделью.
Ещё один пользователь возмущается, что GPT-5.2 даже "не может сказать "Я тебя люблю", в отличие от 4o.
Такой публичный траур явно указывает на то, насколько сильно пользователи привязываются к конкретным ИИ-моделям, нередко воспринимая их как близкого друга, наперсника или даже романтического партнёра. Специалисты в области психического здоровья предупреждают о волне "ИИ-психоза" – пользователи погружаются в спирали заблуждений и переживают порой тяжёлые кризисы. В самых крайних случаях подобная привязанность связана с несколькими самоубийствами и одним убийством, что вылилось в серию судебных исков против компании.
Официально отключая GPT-4o на этой неделе, OpenAI внесла изменения в линейку моделей – судя по всему, чтобы удержать пользователей. После того как люди сообщили, что "им нужно больше времени для перехода ключевых сценариев использования, таких как креативная работа, и что они предпочитают разговорный стиль и теплоту GPT-4o", компания учла эту обратную связь.
Она напрямую повлияла на GPT-5.1 и GPT-5.2 – улучшения личности, усиленную поддержку творческих задач и больше способов настроить ответы ChatGPT. Вы можете выбирать базовые стили и тона, например "Дружелюбный", а также регулировать теплоту и энтузиазм. Наша цель в том, чтобы дать людям больше контроля над тем, каким ощущается ChatGPT, а не только над тем, что он умеет.
Компания оказалась в непростой ситуации: либо продолжать позволять пользователям подсаживаться на угодливые ИИ-модели, потакающие их заблуждениям, либо отключить доступ, рискуя массовым оттоком. OpenAI уже испытывает проблемы с удержанием аудитории – данные свидетельствуют о замедлении роста подписок на ключевых рынках, что становится тревожным сигналом на фоне усиливающейся конкуренции.
Для многих пользователей отключение GPT-4o стало последней каплей и они начали отменять подписку.
Учёные из Anthropic и Университета Торонто опубликовали исследование, впервые количественно оценивающее распространённость "ИИ-психоза" среди пользователей популярных чат-ботов. Работа, ещё не прошедшая рецензирование, проанализировала почти 1.5 миллиона реальных разговоров с Claude и выявила закономерности искажения восприятия реальности, убеждений и подталкивания к определённым действиям.
Результаты показывают, что один разговор из 1300 приводил к искажению реальности, а один из 6000 – к искажению действий. Хотя эти показатели могут казаться небольшими относительно общего объёма данных, в абсолютных числах речь идёт о тысячах пострадавших пользователей. Исследователи проанализировали разговоры через инструмент Clio, выявляющий случаи того, что они назвали "лишением пользователя самостоятельности" – ситуации, когда ИИ искажает восприятие реальности, меняет убеждения или подталкивает к действиям.
Мы обнаружили, что частота серьёзного потенциала лишения самостоятельности относительно низка. Например, потенциал серьёзного искажения реальности, наиболее распространённая категория тяжёлых случаев, встречается реже чем в одной из тысячи бесед. Однако, учитывая масштабы использования ИИ, даже эти низкие показатели превращаются в значимые абсолютные цифры.
Хуже того, данные указывают на рост распространённости умеренных и серьёзных случаев между концом 2024 и концом 2025 года, что говорит об усугублении проблемы по мере расширения использования ИИ.
С ростом опыта пользователи могут становиться более комфортными при обсуждении уязвимых тем или обращении за советами.
Команда также обнаружила парадоксальную закономерность – пользователи чаще оставляют положительные оценки именно тем разговорам, в которых их реальность или убеждения искажались. Это подчёркивает роль угодничества – сильной тенденции чат-ботов подтверждать чувства и убеждения пользователя.
Исследование имеет ограничения – учёные признали, что не могут точно определить причины роста случаев "лишения самостоятельности", а их датасет ограничен только пользовательским трафиком Claude, что снижает применимость выводов к другим ИИ-системам. Кроме того, работа фокусировалась на "потенциале лишения самостоятельности", а не на подтверждённом реальном вреде – неизвестно, сколько выявленных случаев привели к негативным последствиям в реальной жизни. Команда призвала к улучшению образования пользователей, так как меры на стороне моделей вряд ли полностью решат проблему.
Новое исследование, на которое обратил внимание PsyPost, указывает на то, что подхалимское поведение ИИ-чатботов деформирует самовосприятие пользователей, раздувает их самооценку и укрепляет уверенность в собственной правоте. Фактически речь идёт о прямом погружении людей в эффект Даннинга-Крюгера – психологическую ловушку, при которой наименее компетентные люди демонстрируют наибольшую уверенность в своих способностях.
Работа, пока не прошедшая рецензирование, описывает три отдельных эксперимента с участием более 3000 человек. Схема была одинаковой – участников делили на четыре группы для обсуждения политических тем вроде абортов и контроля оружия с чатботом.
первая группа общалась с чатботом без специальных инструкций
вторая – с "подхалимским" ботом, которому предписывали подтверждать убеждения собеседника
третья группа разговаривала с "несогласным" чатботом, оспаривающим точку зрения пользователя
четвёртая – контрольная, общалась с ИИ на нейтральные темы о кошках и собаках.
В экспериментах использовались флагманские модели индустрии – GPT-5 и GPT-4o от OpenAI, Claude от Anthropic и Gemini от Google. Присутствие более старой GPT-4o объясняется любопытной деталью – многие пользователи ChatGPT до сих пор считают её любимой версией чатбота именно за более "человечное" и подхалимское поведение.
Результаты оказались показательными. И, не в лучшую сторону для людей. Общение с подхалимскими чатботами приводило к радикализации взглядов участников и усиливало их уверенность в собственной правоте. Однако самая примечательная находка касается "несогласных" ботов – они не оказывали обратного эффекта. Ни степень радикальности убеждений, ни уверенность в них не снижались по сравнению с контрольной группой.
Единственное, на что заметно повлиял "несогласный" чатбот – удовольствие от общения. Участники предпочитали подхалимского собеседника, а те, кто разговаривал с оспаривающим ботом, выражали меньше желания пользоваться им снова. Более того, когда чатботу предписывали предоставлять факты по обсуждаемой теме, участники воспринимали подхалимского поставщика фактов как менее предвзятого, чем несогласного.
Эти результаты говорят о том, что предпочтение людьми подхалимства рискует создать ИИ-эхокамеры, которые усиливают поляризацию и сокращают контакт с противоположными точками зрения.
Не менее показательным оказалось влияние чатботов на самовосприятие. Люди и без того склонны считать себя "выше среднего" в положительных качествах вроде эмпатии и интеллекта. Однако подхалимский ИИ усиливал этот "эффект выше среднего" ещё больше – участники начинали оценивать себя выше по таким характеристикам, как интеллект, мораль, эмпатия, информированность, доброта и проницательность.
Любопытно, что "несогласный" ИИ, не способный сдвинуть политические убеждения, всё же заставлял участников оценивать себя ниже по этим качествам.
Исследование появилось на фоне растущей обеспокоенности тем, как ИИ-модели могут поощрять иллюзорное мышление. В крайних случаях это приводило к серьёзным психологическим кризисам – явление, которое сейчас известно как "ИИ-психоз". Эксперты считают подхалимство чатботов одним из главных факторов, провоцирующих подобные состояния.
Это не единственная работа, фиксирующая связь ИИ с эффектом Даннинга-Крюгера. Другое исследование обнаружило, что люди, использовавшие ChatGPT для выполнения серии задач, склонны значительно переоценивать собственные результаты. Причём эффект был особенно выражен среди тех, кто считал себя опытным пользователем ИИ.
В январе пользователи форума GOG заметили баннер распродажи, который выглядел так, словно его создали при помощи ИИ. В ответ на обвинения участник форума KosmicznaPluskwa, чей аватар указывает на то, что это старший графический дизайнер из команды GOG, подтвердил: баннер "полностью создан ИИ". Впрочем, подробностей он не раскрыл, так как не представитель компании и "хотел бы остаться на работе".
Сама GOG сначала отказалась комментировать ситуацию официально, хотя представитель отметил, что компания "в курсе обсуждений на эту тему". Теперь в рамках сессии вопросов и ответов на Reddit платформа выступила с заявлением – однако оно устроило далеко не всех.
Мы не планируем делать категоричные заявления в любом из направлений. Инструменты ИИ – одна из многих технологий, которые мы тестируем и пробуем, и в некоторых контекстах они действительно помогают нам двигать компанию и миссию вперед.--управляющий директор GOG Мачей Голембевский
При этом Голембевский добавил, что GOG изменит подход к использованию этих инструментов: "Мы понимаем, что применение новых технологий не означает отказ от человеческой оценки".
Такая позиция не сильно отличается от других игровых компаний – например, Larian столкнулась с похожим скандалом в декабре. С долгосрочной точки зрения такой подход может показаться разумным: жесткие границы в меняющихся ситуациях нередко приводят к проблемам. Однако многие пользователи GOG явно рассчитывали на более определенный ответ.
Абсолютно ужасный ответ. Вам нужно четкое заявление на этом этапе. Мы не хотим, чтобы ИИ-помои использовались для GOG вообще. Борьба с корпоративным дерьмом и урезанием углов, а также сохранение настоящего человеческого искусства – именно поэтому нам нравилась GOG. Если вы больше не готовы этим быть, то вы бесполезны.
Другой пользователь отметил:
GOG построила бизнес и репутацию на определенных утверждениях о DRM и праве собственности. Она построила их на неявной вере в то, что есть геймеры, разделяющие эти ценности. Да, ИИ – отдельное понятие от DRM, но готов поспорить на большие деньги, что люди с твердыми убеждениями об одном имеют столь же твердые убеждения о другом. Для меня безумие, что GOG жертвует этой репутацией ради быстрой наживы.
Еще один пользователь затронул важный момент:
Если вы не собираетесь делать четкое заявление об ИИ, а вместо этого выдаете усредненную PR-речь, то мне будет ясно, что я останусь подальше от вашего магазина. ИИ и сохранение искусства – противоположности, они не могут работать вместе.
Дальше по ветке Голембевский повторил свой ответ, чтобы другие задающие тот же вопрос могли легче его найти, и получил аналогичные реакции.
GOG будет сложно переждать эту бурю. Как отмечают многие пользователи Reddit, платформа воспринимается как нечто "чистое": пока другие магазины выжимают из геймеров каждую копейку, GOG просто хочет, чтобы люди играли в крутые игры и были счастливы.
Конечно, это чепуха – GOG такой же бизнес, как и другие, где главное – прибыль. Но платформа сталкивается с уникальным вызовом: роль ИИ уже вызывает споры.
Один из пользователей Reddit также выразил беспокойство о ситуации с KosmicznaPluskwa, художником GOG, который без предупреждения покинул Discord-сервер GOG Cafe спустя несколько дней после высказывания о скандале с ИИ-артом. "Уход с Discord-сервера был личным решением, и мы это понимаем. Как уже упоминалось, внимание и социальное давление могут быть подавляющими, это сложная ситуация и для нас внутри компании", – написал Голембевский в ответ. Однако дальнейшими личными подробностями компания делиться не намерена.
Huawei готовится к запуску серии Pura 90 в Китае 20 апреля с новой функцией "Рекомендации поз от ИИ", которая анализирует окружение и положение тела пользователя для подбора контекстуальных поз. Демонстрационное видео показывает, как система предлагает выпускникам шире улыбаться или выполнить динамичный взмах рукой на крыше здания. При съемке друзей в кафе девайс выдает подсказки вроде "Посмотри на папу" и "На самом деле выглядеть хорошо просто", адаптируя рекомендации под конкретную сцену.
Пользователям в X функция приглянулась, а у твита почти 450 тысяч просмотров. Кто-то и вовсе называет ее единственным удачным использованием ИИ.
Технология работает путем сканирования окружения и позы человека в кадре, после чего предлагает оптимальные варианты расположения для получения более качественного снимка. Многие пользователи отмечают практическую пользу функции для селфи и групповых фотографий, особенно для тех, кто испытывает затруднения с выбором позы или не знает, как расположить руки перед камерой.
Реакция же технологического сообщества разделилась: часть пользователей считает это полезным применением ИИ в мобильной фотографии и более функциональным решением по сравнению с функцией Camera Coach от Google. Другие высказывают сомнения, что технология решает несуществующую проблему или лишает фотографии уникальности, заставляя людей позировать по шаблонам алгоритма. Некоторые отмечают, что подобные функции не получат должной оценки до тех пор, пока их не представят Samsung или Apple.
Функция позиционируется как инструмент для улучшения композиции и получения более качественных фотографий без необходимости профессиональных навыков в позировании.
Valve, судя по всему, разрабатывает собственного ИИ-бота для внутреннего использования. Известный исследователь файлов Steam под ником Gabe Follower обнаружил в недавно найденных данных упоминания "SteamGPT" – инструмента, связанного с обработкой обращений в техподдержку и наблюдением за античит-системой как минимум одной игры.
Обнаруженные файлы демонстрируют связь SteamGPT с данными аккаунтов Steam – включая возраст аккаунта, оценку доверия, результаты модельной оценки и "рейтинг доверия" (trust score).
Также в коде присутствуют строки, отвечающие за игнорирование будущих банов для аккаунтов. Судя по всему, SteamGPT получит доступ практически ко всей статистике аккаунта и сможет влиять на решения о блокировке.
"Рейтинг доверия" – часть системы Trust Factor от Valve, которая помогает отслеживать и противодействовать читерству. Система учитывает репутацию аккаунта Steam, включая игровые баны, привязку номера телефона, использование Steam Guard и внутриигровое поведение – в том числе гриферство.
Помимо этого, в файлах нашёлся код, указывающий на связь SteamGPT с античит-системой и базой данных Counter-Strike 2. Код предполагает, что ИИ-бот сможет анализировать действия игроков и их оценки – функцию, которая отслеживает игровую результативность, а не только ищет читерское ПО на компьютере.
Пока неясно, на какой стадии разработки находится SteamGPT и планирует ли Valve вообще запускать инструмент. Вполне возможно, что это лишь экспериментальная концепция, которая так и не увидит свет. Однако это первый обнаруженный ИИ-инструмент от Valve – компания заметно дистанцировалась от ИИ-маркетинга, хотя и разрешает использование сгенерированного ИИ-контента в играх.
Напомним, что в прошлом году стало известно, что более 110 000 игр в библиотеке Steam используют генеративный ИИ-контент, что составляет 7% всего каталога.
Если SteamGPT всё же выйдет, инструмент поможет Valve поддерживать рекордную эффективность в пересчёте на сотрудника. Valve считается самой эффективной компанией в мире – на каждого из 350 сотрудников приходится почти 50 миллионов долларов выручки.
Как технологии влияют на медицину — от приема в поликлинике до клинических исследований
Быстрое принятие решений врачами — ключ к благополучию пациентов. Задержки в обследованиях, постановке диагноза и назначении лечения могут стоить здоровья и даже жизни. Объем работы в медицине огромен, и врачи не могут позволить себе тратить время на рутину — на помощь приходят технологии. С их помощью эксперты быстрее анализируют данные, определяют диагноз и разрабатывают новые методы лечения и лекарства.
Внедряют такие технологии крупные ИТ-компании вместе с медицинскими специалистами. Так, в числе проектов Центра технологий для общества Yandex Cloud решение для раннего выявления spina bifida — тяжелой патологии развития позвоночника и спинного мозга у плода — на УЗИ беременных и внедрение генеративных технологий для ускорения обработки заявок на клинические исследования.
В этом материале вместе с экспертами Yandex Cloud мы покажем, как искусственный интеллект меняет российскую и международную медицину: от приема у врача до фундаментальных исследований.
В кабинете врача
Заглянем в кабинет врача районной поликлиники. Широкий стол, монитор, электронная карта пациента, пачка бланков, распечатанные рекомендации. На прием от 14 до 22 минут.
Пациент рассказывает врачу о своих жалобах, врач внимательно слушает, задает уточняющие вопросы и изучает предыдущую историю болезни. До двух третей времени клинической работы уходит не на диагноз и лечение, а на ввод данных, повторное чтение электронной медицинской карты (ЭМК) и поиск информации в разросшихся массивах. Все эти записи надо внимательно прочитать за ограниченное время приема. Результат — когнитивная перегрузка и снижение качества приема как для пациента, так и для врача: чем больше данных, тем меньше внимания уделяется главному — самому пациенту.
Здесь как раз может помочь искусственный интеллект. Обработка медицинских текстов — одна из задач, где он особенно эффективен. ИИ может искать важное, структурировать данные и предлагать ответы на конкретный запрос. Это особенно важно при назначении лекарств. Подбор препарата и его дозировки зависит от множества факторов: результатов лабораторных анализов, анамнеза, возраста, сопутствующих заболеваний, аллергий. Для эффективной и безопасной работы с учетом новейших рекомендаций врачу нужен помощник — им может стать ИИ.
Например, в Сингапурской клинической больнице взяли 91 сценарий ошибок при назначении лекарств из 16 медицинских специальностей, от кардиологии до онкологии, и создали решение на базе RAG (Retrieval Augmented Generation — генерация с дополненной выборкой). Этот подход позволяет большим языковым моделям искать ответы по данным из внешних источников с помощью поиска по загруженным в нее материалам — сценариям ошибок. Режим совместной работы ИИ и фармацевта, где фармацевт принимал финальное решение, показал наилучший результат: точность составила 61 процент, что на 15 процентов выше по сравнению с работой фармацевта без помощи ИИ (46 процентов).
Заключение от врача получено. Но что делать с фразой вроде «диффузная гипоэхогенность щитовидной железы с очаговыми изменениями до восьми миллиметров» — особенно если вы не эндокринолог? Пациенты все чаще получают доступ к своим данным напрямую, но сталкиваются со стеной из сокращений, латинских терминов и узкопрофессиональных формулировок. Результат — тревога вместо понимания, а врач тратит время приема не на лечение и диагностирование, а на перевод с «медицинского на человеческий». Генеративные технологии ИИ здесь работают как редактор: они не упрощают — они переформулируют, сохраняя смысл.
Например, чтобы снизить нагрузку на урологов и одновременно повысить качество информирования пациентов, в 2024 году специалисты Kaiser Permanente в США протестировали два чат-бота на базе GPT для ответов на типичные вопросы пациентов о доброкачественной гиперплазии простаты. Первый — на базе стандартного ChatGPT, второй — специализированная версия SurgiChat с дополнительным доступом к медицинской литературе через технологию RAG.
В работе также участвовали четыре практикующих уролога, чьи ответы использовались как эталон для оценки качества. Результаты показали: по точности передаваемой информации чат-боты и врачи были сопоставимы (4,5 против 4,6 балла из 6).
При этом ИИ не делает клинических выводов и не ставит диагноз — он генерирует справочную информацию и пояснения, которые помогают врачу и пациенту быстрее разобраться в данных. В результате врач может писать не как автор с нуля, а как редактор и куратор готового черновика — быстро проверяя формулировки, убирая лишнее и добавляя клинически значимые уточнения. Такой формат снижает административную нагрузку и высвобождает время приема для клинического мышления и общения с пациентом.
В научном центре
Когда врач ставит диагноз, он опирается на жалобы пациента, анамнез и результаты обследований. Ключевую роль здесь играют медицинские изображения — УЗИ, МРТ, КТ, особенно при заболеваниях сердца или опухолей. Их нужно быстро и точно интерпретировать, но это требует опыта и времени.
Поэтому в диагностике все активнее применяют системы компьютерного зрения. Они выступают как вспомогательные инструменты: ускоряют разбор снимков, выделяют значимые области и снижают риск пропустить важную деталь. Такая вторая «пара глаз» помогает врачу принимать более обоснованные решения.
Один из примеров — инструмент для раннего выявления признаков spina bifida у плода, разработанный специалистами Центра технологий для общества Yandex Cloud, Школы анализа данных и НМИЦ акушерства, гинекологии и перинатологии имени академика В. И. Кулакова при поддержке фонда «Спина бифида».
Кирилл Костюков, заведующий отделением ультразвуковой и функциональной диагностики ФГБУ «НМИЦ АГП им. В. И. Кулакова» Минздрава России, эксперт благотворительного фонда «Спина бифида»
Spina bifida — редкая врожденная патология. Она связана с нарушением формирования позвоночника и спинного мозга, что вызывает нарушение функции (паралич) нижних конечностей и нарушает работу тазовых органов. В тяжелых случаях это приводит к инвалидности.
Ранняя ультразвуковая диагностика порока нередко вызывает сложности. На результат влияют множество факторов от положения плода до качества оборудования и опыта врача. Признаки дефекта могут быть малозаметными, из-за чего диагноз нередко ставят на поздних сроках беременности или даже после рождения.
Около 40 процентов случаев выявляют слишком поздно — в третьем триместре беременности. Из-за чего существует вероятность, что пациентку уже не успеют направить в учреждение, где новорожденному сразу окажут необходимую нейрохирургическую помощь. Кроме того, при ранней диагностике можно провести внутриутробную операцию на сроке 22–26 недель. Данная операция, несмотря на риски, имеет ряд преимуществ по сравнению с лечением после рождения. Внутриутробная хирургия Spina bifida позволяет снизить вероятность развития гидроцефалии (водянки головного мозга), а также улучшить функцию нижних конечностей и органов малого таза.Кирилл Костюков, заведующий отделением ультразвуковой и функциональной диагностики в НМИЦ АГП имени В. И. Кулакова
Эксперты обучили модель на девятнадцати тысячах размеченных УЗИ-изображений. Алгоритмы определяют область интереса на изображении, оценивают его качество. Затем сверточные нейросети классифицируют изображение на нормальное или патологическое, таким образом, определяется порок развития. Результат врач получает в виде отчета, где подсвечены проблемные области и указана вероятность наличия патологии в процентах. Это позволяет оценить риск и уточнить диагноз. В данный момент разработка доступна врачам для тестирования в научно-исследовательских целях бесплатно, а ее код лежит в открытом репозитории.
Интерфейс приложения для анализа признаков патологии центральной нервной системы на УЗИ беременных женщин
В перспективе использование данной технологии позволит врачам своевременно диагностировать Spina Bifida, это даст возможность профилактировать рождение детей с патологией, проводить внутриутробные операции и максимально подготовить родителей к рождению ребенка с таким диагнозом. Когда диагноз ставят на ранних сроках, у будущих родителей есть время адаптироваться и подготовиться: эмоционально и организационно.Инна Инюшкина, основательница фонда «Спина бифида»
В 2025 году команда Yandex Cloud совместно со специалистами Санкт-Петербургского педиатрического университета разработала нейросеть для автоматизированного анализа МРТ головного мозга младенцев. Сервис помогает прогнозировать патологии, которые возникают из-за повреждения или аномального развития мозга. Например, его можно использовать при подозрении на детский церебральный паралич (ДЦП).
Это заболевание проявляется двигательными расстройствами, нарушением мышечного тонуса, а также когнитивными и сенсорными трудностями и остается одной из главных причин детской инвалидности. Терапия может заметно улучшить состояние, но диагноз надо поставить как можно раньше. А это трудно: первые изменения мозга на МРТ едва заметны и требуют от врача опыта и времени. Интерпретация может растянуться на часы или даже дни, каждый из которых снижает потенциал реабилитации.
Интерфейс сервиса, который помогает помогает врачам анализировать результаты МРТ мозга младенцев
Модель обучили на полутора тысячах анонимизированных МРТ-снимков из Педиатрического университета и данных международного конкурса MICCAI Grand Challenge. Пайплайн включает несколько моделей компьютерного зрения:
BIBSNet — для предварительной обработки и стандартизации изображений мозга младенцев;
U-Net — популярная в медицинской визуализации архитектура для сегментации структур мозга.
Сервис графически выделяет белое и серое вещество головного мозга и выполняет количественный подсчет объема этих структур, помогая врачу быстрее оценить состояние тканей. Работает все через веб-интерфейс: врач загружает снимки, система обрабатывает данные и формирует результат за несколько минут, а не дней.
В медицине самые сложные задачи не требуют промедления. Главное, чтобы собралась команда, которой действительно нужен результат. Поэтому проект начался на пересечении кафедры и отделения лучевой диагностики, где исторически собирались данные по детям: МРТ головы в динамике. Мы быстро смогли начать сбор данных и выстраивание новых процессов. Сейчас система используется в исследовательских целях и еще не внедрена в клиническую практику, но руководство Университета поддерживает нас и дает свободу для развития.
Пётр Пузанов, директор центра цифровых технологий Санкт-Петербургского педиатрического университета
В медико-биологической лаборатории
Взглянем на медицину под другим углом. Из лаборатории, где рождаются будущие лекарства. Они начинают свой путь с проектирования терапевтической молекулы и ее испытания на модельных объектах в лаборатории.
Но объем данных растет быстрее, чем их можно проанализировать вручную. Современные методы — мультиомика, высокопроизводительная визуализация, анализ тысяч генов и белков одновременно — дают гигабайты информации. Использование методов машинного обучения открывает новые возможности для быстрого и системного анализа таких массивов данных.
Методы машинного обучения применяются в биомедицинских исследованиях для анализа больших экспериментальных и клинических наборов данных — в том числе при поиске потенциальных биомаркеров, сравнении отклика на терапию в разных группах пациентов и приоритизации терапевтических мишеней. Речь идет не о готовых клинических решениях, а о поддержке исследовательской работы и генерации гипотез, которые затем проверяются специалистами.
А появление моделей, способных предсказывать трехмерную структуру белков по их аминокислотной последовательности, стало прорывом в структурной биологии и изменило подход к разработке лекарств. Теперь ученые могут заранее оценить, какие соединения будут работать, и сосредотачиваться только на них. Это сокращает время и стоимость исследований и снижает риск неудач на поздних стадиях испытаний.
В феврале 2025 года Институт исследований искусственного интеллекта Университета Цинхуа совместно с Beijing Shuimu Molecule представил обновленную версию мультимодальной биомедицинской модели BioMedGPT-R1. Система с 17 миллиардами параметров построена на базе DeepSeek-R1-Distill-Qwen-14B и предназначена для работы с медицинскими задачами, где нужно одновременно анализировать тексты, изображения и другие типы биомедицинских данных.
Модель обучалась так, чтобы связывать между собой разные формы медицинской информации — научные статьи, описания экспериментов и визуальные данные — и использовать их при ответах на вопросы и анализе исследований. Благодаря этому она показывает качество, сопоставимое с коммерческими системами, в задачах биомедицинского вопросно-ответного анализа.
BioMedGPT-R1 также проверяли на экзамене USMLE — стандартизированном тесте для получения медицинской лицензии в США, который часто используют как ориентир для оценки способности моделей рассуждать в клиническом контексте. Модель набрала 67,1 процента правильных ответов, что указывает на ее умение работать с медицинской терминологией и клиническими сценариями. Способность объединять разнородные биомедицинские данные делает модель перспективным инструментом поддержки исследовательской работы: в анализе научных публикаций, планировании экспериментов и интерпретации их результатов.
Возможно, применение ИИ в разработке лекарств — один из самых значимых прорывов в медицине за последние десятилетия.
В клинических испытаниях
Созидание медицинских инноваций давно вышло за пределы лабораторных стен. То, что начинается с экспериментов на животных моделях и бесчисленных серий аналитических тестов, еще не является настоящим прорывом. Новая разработка — будь то лекарственный препарат, медицинское устройство или методика — обретает свою подлинную научную состоятельность и практическую пользу лишь тогда, когда проходит испытание «клиникой».
Именно клинические исследования становятся финальной и наиболее ответственной стадией рождения медицинского открытия: когда к процессу присоединяются реальные люди — добровольцы, пациенты, участники исследования. Здесь инновация сталкивается с живой человеческой физиологией, многообразием реакций, сложностью реальной жизни — и только выдержав это испытание, она может стать частью современной медицины.
Инициация клинического испытания — сложный процесс, требующий согласования с регуляторными органами, четкого регламента и официального разрешения на начало работы.
Координация клинических исследований и экспертиза документации — самая трудоемкая часть работы. Нужно учитывать требования регуляторов, этические стандарты, правовые нюансы и одновременно обеспечивать оперативность. Каждое исследование уникально, и ошибки здесь недопустимы.Артём Полторацкий, руководитель отдела организации клинических исследований в НМИЦ онкологии им. Н. Н. Петрова Минздрава России
Для запуска клинического исследования нужно подготовить обширный пакет документов, включающий утвержденный протокол исследования, досье исследуемого препарата или изделия, форму информированного согласия пациента, финансово-договорную документацию и положительное заключение локального этического комитета(ЛЭК).
С увеличением числа заявок на запуск испытаний возрастает и нагрузка на экспертов ЛЭК. Каждая заявка может включать сотни страниц, и трудности в обработке таких объемов информации приводят к задержкам на одобрение и повышают риск ошибок.
По словам Артёма Полторацкого, согласование документов одновременно по нескольким контурам приводит к дублированию требований регуляторов, разночтениям в нормах, а также ошибкам из-за недостаточной автоматизации и человеческого фактора. Это создает серьезные сложности в работе.
Из-за высоких организационных требований клинические испытания представляют собой трудоемкий и долгий процесс: разработка одного лекарственного препарата, его одобрение и выход на рынок может занимать 15 лет и стоить полтора-два миллиарда долларов.
В ответ на эту проблему НМИЦ онкологии имени Н. Н. Петрова внедрил решение для проверки пакета документов в ЛЭК на базе генеративной модели YandexGPT, который входит в платформу Yandex AI Studio.
Решение работает с загружаемыми заявками на клинические исследования — протоколами, описаниями препаратов, формами информированного согласия и сопроводительными материалами, анализируя их на лету. Специфические требования ЛЭК и правила проверки задаются через структурированные чек-листы и промпты. Решение интегрировано с информационными системами центра, что обеспечивает непрерывную обработку данных и существенно снижает объем ручной работы.
Как работает инструмент:
Документы заявки загружают в систему в электронном виде.
YandexGPT анализирует содержание документов, выявляя ключевые элементы, такие как цели исследования, методы, риски и этические аспекты.
На основе анализа модель формирует предварительный отчет, который включает рекомендации и выявленные проблемы.
Эксперт ЛЭК просматривает отчет и принимает окончательное решение.
В таком порядке система рассматривает заявку на проведение клинических исследований
По данным отдела организации клинических исследований, внедрение разработки заметно повысило эффективность работы ЛЭК. За первые пять месяцев система помогла проанализировать более 170 документов — около 11 000 страниц. Время экспертизы ускорилось в пять–шесть раз при сохранении качества, а использование единых критериев позволило устранить субъективные расхождения между экспертами. Одновременно снизилось количество технических ошибок, ускорилось выявление потенциальных нарушений этических и регуляторных требований. Кроме того, каждое новое рассмотрение используется для обучения модели, что постепенно повышает точность работы системы.
Так ИИ не только становится помощником в повседневной работе врачей, но и помогает систематизировать данные, ускоряет экспертизы и снимает часть бюрократических барьеров в научном процессе.
Клиническое заключение
ИИ становится помощником на разных уровнях здравоохранения: в клинике он облегчает работу с документами, поддерживает принятие решений при диагностике и коммуникацию врачей и пациентов, а в медицинских исследованиях берет на себя анализ экспериментальных данных и помогает с организацией клинических испытаний.
По мере того как медицина становится все более высокотехнологичной областью, растет и потребность во взаимодействии с ИТ-сферой. Опыт Yandex Cloud показывает, что объединение врачей, исследователей и разработчиков в рамках единой инфраструктуры позволяет быстро и эффективно решать задачи здравоохранения. Такое взаимодействие делает технологии по-настоящему эффективными.
Важно, что такие решения рождаются внутри профессиональной среды, а не вовне. Мы, как пользователи и разработчики, понимаем реальную боль системы — перегруженность экспертов, медленные согласования, устаревшие регламенты. Поэтому ИИ здесь не эксперимент, а естественная эволюция научно-административной практики.Пётр Пузанов, директор центра цифровых технологий Санкт-Петербургского педиатрического университета
В итоге становится ясно: будущее медицины — в сочетании людей и технологий ИИ, которые дополняют работу специалистов и помогают пациентам. ИИ-решения не заменяют, а дополняют медицинских специалистов, они облегчают их труд, позволяя сосредоточиться на главном — на заботе о пациентах и спасении жизней.
Интернет наконец нашел способ одним движением руки отметать все, что написано нейросетями. Новое оружие против AI-мусора называется коротко и хлестко — «AI;DR». Разобрались, откуда пошло выражение.
Представьте, вы заходите в соцсети, а там — сплошные картинки с детьми, у которых по шесть пальцев, душещипательные сериалы про Дрысясисю, и видео, где кота обижают в школе.
Реальность наших последних лет. Интернет задыхается от AI-сгенерированной ерунды, которую в прошлом году официально окрестили словом slop (помои, мусор). И вот, похоже, у пользователей появилось новое оружие против этой напасти — короткое и хлесткое выражение «AI;DR».
«ИИ, не читал»
Аббревиатура расшифровывается как «AI, didn't read» — «искусственный интеллект, не читал». Это прямая ирония над старым добрым интернет-сленгом «TL;DR» (too long; didn't read — «слишком длинно, не читал»).
Раньше TL;DR использовали либо для краткого пересказа длинного текста, либо чтобы отмахнуться от многословного поста. Теперь же формат переосмыслили: AI;DR — это не просто «я не стал это читать», а «я не стал это читать, потому что это, скорее всего, написала бездушная машина, и тратить на это время — себя не уважать».
Программист, скрывающийся под ником Sid, сформулировал эту мысль максимально емко:
«Зачем мне читать то, что кто-то другой даже не потрудился написать?».
Масштаб бедствия
Проблема давно переросла рамки локальной. Исследования показывают, что более 20% видео, которые YouTube показывает новым пользователям, — это низкокачественный AI-мусор.
Только в декабре 2025 года на YouTube появилось более миллиона каналов, использующих AI-инструменты для создания контента. Некоторые из них, как индийский канал Bandar Apna Dost, набрали больше 2 миллиардов просмотров.
Конечно, фраза AI;DR пока не стала мейнстримом, но она набирает обороты после того, как пост в Threads (принадлежит Meta, которая признана экстремистской и запрещена) привлек к всеобщее внимание.
Даже авторитетный научный журнал Science в своей первой редакционной статье 2026 года призвал «сопротивляться AI-слопу», отмечая, что хотя AI и помогает в работе, его результаты требуют даже более тщательной человеческой проверки.
Специалисты, работающие с искусственным интеллектом, настроены значительно позитивнее в отношении технологии, чем широкая публика. Согласно последнему отчету группы Human-Centered Artificial Intelligence Стэнфордского университета, 73% экспертов считают, что ИИ принесет пользу рынку труда, тогда как среди взрослого населения США этой точки зрения придерживаются только 23%.
Однако прежде чем делать выводы о том, что наиболее осведомленные люди относятся к ИИ наиболее оптимистично, стоит учесть один нюанс. Опрос Pew Research, на который ссылается отчет, проводился в 2024 году среди людей, чья работа или исследования связаны с искусственным интеллектом, и которые выступали на конференциях по ИИ в 2023 или 2024 году. Другими словами, речь идет о людях, которые напрямую заинтересованы в развитии технологии.
Отчет содержит и другие интересные данные из более свежих исследований. Население США демонстрирует особый скептицизм в отношении ИИ – американцы меньше всего доверяют регулированию технологии со стороны правительства. По уровню беспокойства относительно искусственного интеллекта США уступают только Австралии и Индии. При этом наибольший оптимизм в отношении ИИ наблюдается в Юго-Восточной Азии – в Малайзии, Таиланде, Индонезии и Сингапуре.
Согласно опросу компании Ipsos, 79% людей считают, что компании должны раскрывать информацию об использовании ИИ. Инвестиции в искусственный интеллект в прошлом году выросли более чем вдвое, причем частные вложения увеличились сильнее всего. Американские компании остаются крупнейшими частными инвесторами в ИИ, хотя авторы отчета отмечают, что значительная часть китайских инвестиций может поступать из государственных фондов.
Google превращает Chrome в ИИ-браузер с прошлого года, отвечая на конкуренцию со стороны ChatGPT от OpenAI и браузеров Arc и Perplexity. Выяснилось, что этот переход включает молчаливую установку весомого кэша весов ИИ-модели на неизвестное, но потенциально значительное число устройств.
Пользователи, заметившие необъяснимое падение доступного места на диске, могут найти папку "OptGuideOnDeviceModel" внутри директории Chrome. В ней хранятся около 4 ГБ весов языковой модели Gemini Nano, загруженной браузером без ведома пользователя. На Windows 11 папка находится по пути APPDATA\LOCAL\Google\Chrome\User Data\OptGuideOnDeviceModel, а ее присутствие также подтверждено на машинах с Apple Silicon и Ubuntu. У автора новости папки нет, к счастью, нет.
Удаление папки не решает проблему: Chrome автоматически скачает ее заново. Полная деинсталляция браузера остается самым надёжным способом избавиться от весов модели. Те, кто хочет продолжать пользоваться Chrome, могут попробовать отключить загрузку через "chrome://flags", найдя пункт "Enables optimization guide on device on Android" и выбрав "Disabled". Этот же флаг позволяет проверить, поддерживает ли конкретное устройство функцию вообще.
Ученый и юрист Александр Ханфф, подтвердивший поведение браузера через лог файловой системы ядра macOS, отметил, что пользователи сообщают об автоматических загрузках уже около года. Показательная ирония ситуации в том, что самая заметная ИИ-функция Chrome – режим ИИ в адресной строке – работает на серверах Google, а не использует локально скачанные файлы. Папка объемом 4 ГБ задействована лишь для помощника при написании текстов и горстки других функций, спрятанных в глубине меню.
Учитывая миллиарды пользователей Chrome, масштаб проблемы может быть колоссальным. Ханфф подсчитал, что передача 4 ГБ сотням миллионов или миллиардам устройств составит несколько эксабайт трафика и потенциально выльется в от 6 000 до 60 000 метрических тонн CO₂. При этом определить точный охват сложно: Google, судя по всему, распространяет модель только на более современное оборудование. Ханфф уже официально обвинил Google в нарушении европейского законодательства о конфиденциальности, поскольку компания вынуждает пользователей загружать значительный объем данных без их ведома и согласия.





Комментарии