Выполнял рейс из Харбина в Шанхай. Набрали высоту, пора завтракать.
В кабину заходит стюардесса, дает мне поднос с вонючей коричневой жижей и мяукает на плохом английском: "Приятный аппетита капитана!"
Это был один из первых рейсов в китайской авиакомпании и я познавал все прелести работы в азиатамском экипаже.
Через минуту стюардесса возвращается с подносом для второго пилота. А там: креветки, красная рыба, пирожное!
Я смотрю на свой поднос. У меня в коричневом киселе плавает взорванная курица с лапами.
Боковым зрением улавливаю взгляд второго пилота-китайца. Он жадно смотрит на мою еду и явно хочет что-то спросить...
Затем он не выдержал:
-Капитана, вы будете вот эту коричневую тарелку есть?
-Не хотелось бы...
-А давайте поменяемся, я креветки и красную рыбу не очень люблю!
-Что же ты раньше молчал!? Я уже месяц давлюсь куриными лапами!
Оказалось, что китайские стюардессы подают капитану самое вкусное, на их взгляд. Хотя бывает, что на борт грузят нормальную человеческую еду, они считают ее не вкусной и оставляют второму пилоту. В итоге капитан ест вонючее коричневое желе с куриными головами, а второй ест пельмешки, креветки и давится пирожными.
Вот так сказывается на русских азиатское чинопочитание.
Если хотите, чтоб я написал несколько статей о работе пилотом и жизни в Китае, напишите коммент.
Спасибо за внимание, друзья!
С вами был летчик Миша из рок-группы SAHALIN. Подписывайтесь, впереди много интересного
"Их монета серебряная, без отверстия и ободка, размером
с семечко тыквы (арбуза, дыни), нормативный вес один фэнь.
На оборотной стороне изображён какой-то всадник, сражающийся цзи (алебардой).
На лицевой стороне их государственное письмо, такое же как в буддийских
(санскритских) сутрах (книгах).
На одной монете всегда несколько десятков знаков, которые нельзя разобрать.
Говорят что письмо используют латинское.
Также латинский язык государственный официальный язык всех западных
стран."
Ян Бинь (Yáng Bīn 楊賓). Очерки
об Ивовой границе (Liǔbiān jìlüè 柳邊紀略).
1707 год (46 год Канси / 康熙四十六年).
Конец 90-х прошлого века. Приехал я по служебным делам в одну контору в
окраинно-промышленном районе С-Пб. Сижу в авто, жду, когда выйдет нужный
человек с подписанными документами (акты, договоры). Из соседнего здания
появляется мажор-метросексуал – молодой парень, одетый в светлое кашемировое
пальто, при нём шёлковый шарф, недешёвые (видно сразу) ботинки, костюм-тройка.
В общем, всё как надо. На ходу разговаривает по телефону, причём держит телефон
(популярнейшая тогда Motorola) напоказ, так,
чтобы всем было видно, насколько крут этот перец. В те времена сотовые телефоны только-только начали появляться, сто́или ещё немерено (кнопочный телефон – около 2 k$). Быстрым шагом подходит к краю
тротуара, и машет рукой в бежевой лайковой перчатке - пытается остановить
какую-нибудь машину. Но все проезжают мимо. Наконец, рядом с ним
останавливается бэха (BMW, стал быть), из неё вылезают трое конкретных коротко
стриженных пацанов в кожанках, с золотыми цепурами на шее. Мажор
незамедлительно получает по морде, телефон получает постоянную прописку в
кармане одного из пацанов, бэха с пробуксовкой рвёт с места, а бывший хозяин
Моторолы остаётся сидеть на несвежем мокром тротуаре. А, вот мне и документы вынесли.
Дратути! Заголовок интригующий, правда?) Интрига - это же так интересно, особенно, если по заголовку вот вообще нифига не понятно, что будет внутри. Итак, запускаем мою логическую цепочку. В Китае живут китайцы. Ну, как минимум, с этим сложно спорить) Группа из Китая, значит в ней играют кто? Праааааааальна, китайцы! Ну а раз в группе играют китайцы - то я со спокойной совестью про нее расскажу.
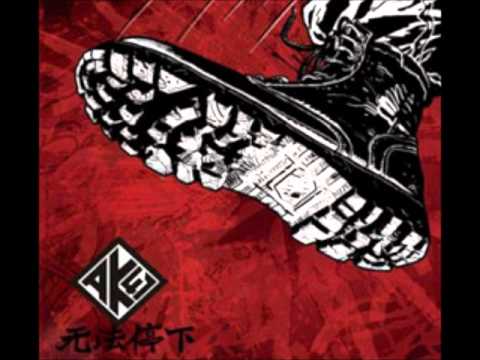
Итак, разглядываем нашего пациента - группу АК-47
Вот он, случай когда китайский АК-47 лучше богомерзкого АК-47 из России! Звучит весьма бодро, не то что наши губошлепы что-то там бубнят. Ну да пройдемся по истории группы, о которой не так уж и много информации в русском сегменте интернетов.
Играют в группе 张智勇 [Чжан Чжи Юн] [он же 老猫 лао мао «старый кот»](вокал), 全磊 [Цюань Лэй] (гитара), 严钦 [Янь Цинь] [он же 豆腐 доуфу «тофу»](бас), 徐凯 [Сю Кай] (сэмплирование), Седрик (ударные), сплошные китайцы, не правда ли?)
https://music.yandex.ru/album/3596110?utm_source=web&utm_medium=copy_link - послушать один из их альбомов можно тут, но так-как коллективов с таким названием - хоть жопой жуй, попало оно совсем не туда, куда надо было. Что о самой группе? А хрен знает, инфы о них я толком не нашел. Все что я нашел : "Одна из наиболее интересных современных рок-групп Китая. Если попытаться охарактеризовать стиль группы, то получится причудливая смесь hardcore, industrial и элементов китайской народной музыки вместе. "AK 47 это новый современный hardcore, который сложно описать, Нужно послушать группу, а лучше посмотреть концерт, чтобы испытать ту энергетику, которую несет творчество группы. Обычно носят коричневую униформу и красную повязку с надписью AK 47. В своей униформе они выглядят скорее армейским военным отрядом, но не группой музыкантов. Они выпустили свой дебютный альбом Chu Fa / Start Off в 2006 году. Группа распалась в 2017 году." Негусто, правда? Увы, именно так. Очень негусто. Но, по информации в группе в ВК, они там пересобрали группу в Китае, но ни подтвердить, ни опровергнуть не представляется возможным. Слушайте хорошую музыку, а плохую не слушайте!
Короткий аудиофрагмент из Common Voice и двухчасовое совещание с перебиваниями, шумом кондиционера и названиями продуктов проверяют систему распознавания речи по-разному. Поэтому место модели в публичном бенчмарке еще не отвечает на главный вопрос бизнеса: сколько времени уйдет на получение пригодного текста из реальной записи.
Для транскрибации звонков, лекций, интервью и субтитров важна не только точность распознавания слов. На итог влияют сегментация длинного файла, работа с тишиной, пунктуация, диаризация спикеров, устойчивость API, поддержка форматов и качество склейки результата.
Ниже сравним OpenAI Whisper Large v3, Microsoft VibeVoice-ASR, Yandex SpeechKit и Google Cloud Speech-to-Text с Chirp 3. Лучшей модели для всех сценариев нет. Для русскоязычных длинных записей сильный движок нужно оценивать вместе с инфраструктурой и постобработкой.
Что умеют модели и где начинаются ограничения
1. OpenAI Whisper Large v3 и Large v3 Turbo
Whisper построен как encoder-decoder Transformer. Исходное семейство обучалось на 680 000 часах многоязычного аудио. Версия Large v3 получила значительно больший обучающий набор: 1 млн часов с неполной разметкой и 4 млн часов псевдоразмеченного аудио. Large v3 Turbo сокращает число слоев декодера с 32 до 4, поэтому работает заметно быстрее ценой небольшого снижения качества.
Сильная сторона Whisper для русского языка проявляется на сложной речи: разговорной лексике, смешении русских и английских терминов, неидеальной дикции и фоне. Модель сразу генерирует текст со знаками препинания и обычно дает более читаемый черновик, чем классические ASR-системы без развитой языковой части.
Но у архитектуры есть ограничение: базовое окно Whisper рассчитано примерно на 30 секунд аудио. Длинный файл все равно обрабатывается последовательно. Библиотека или провайдер режет запись на сегменты, переносит контекст и затем собирает результат.
Именно здесь две системы на одной модели могут показать разное качество. Ошибки появляются не только внутри сегмента, но и на границах: пропавшее слово, повтор фразы, неверный таймкод, потерянный спикер. На тишине или музыке Whisper способен генерировать правдоподобный, но отсутствующий в записи текст. Для production-сценария нужны VAD, контроль повторов, фильтрация пустых сегментов и логика восстановления контекста.
У официального OpenAI API в 2026 году есть и новые модели транскрибации, включая GPT-4o Transcribe и вариант с диаризацией. При этом загрузка файла через стандартные speech-to-text endpoints по-прежнему ограничена 25 МБ. Большие записи приходится сжимать или делить до отправки.
2. Microsoft VibeVoice-ASR
VibeVoice-ASR появился в открытом доступе в январе 2026 года. В официальном репозитории текущая модель обозначена как VibeVoice-ASR-7B. Она принимает до 60 минут непрерывного аудио в пределах контекста 64K и за один проход формирует структурированный результат: кто говорил, когда и что сказал.
Модель объединяет распознавание, таймкоды и диаризацию. Поддерживаются пользовательские hotwords: имена, бренды, аббревиатуры и термины можно передать как контекст. Для технических интервью и корпоративных встреч это полезнее, чем попытка исправлять каждое название после транскрибации.
В официальном тесте MLC-Challenge для русского языка VibeVoice-ASR показал WER 12,40%. Эта цифра характеризует конкретный датасет и протокол. Сравнивать ее напрямую с результатами Whisper, Yandex или Google из других тестов нельзя.
Практическая цена часового контекста заключается в требованиях к развертыванию. Нужны Python, CUDA, FFmpeg, совместимое окружение и NVIDIA GPU. Репозиторий Microsoft предлагает запуск через NVIDIA PyTorch Container. Сторонние сборки снижают порог входа, но не снимают задачи обновления зависимостей, мониторинга памяти и масштабирования очереди.
VibeVoice интересен разработчикам, которым нужен открытый long-form ASR с диаризацией и возможностью дообучения. Для обычного пользователя это пока не готовый облачный продукт. Microsoft прямо рекомендует дополнительное тестирование и разработку перед коммерческим применением.
3. Yandex SpeechKit
SpeechKit изначально ориентирован на русский язык и российские сценарии. Сервис поддерживает потоковое, синхронное и асинхронное распознавание. В актуальной документации синхронный режим рассчитан на короткие файлы до 30 секунд, асинхронный принимает записи длительностью до 4 часов и размером до 1 ГБ.
Утверждение, что Yandex не расставляет пунктуацию, в 2026 году устарело. Режим литературного текста добавляет заглавные буквы и знаки препинания. Есть нормализация чисел и дат, определение дикторов, дообучение и обработка результата с помощью LLM.
Слабое место SpeechKit не в отсутствии базовых функций, а в количестве режимов, параметров и ограничений. Разработчику нужно выбрать API, способ загрузки, формат, модель, нормализацию и схему получения результата. Для длинных файлов применяется асинхронная обработка, поэтому интеграция включает создание операции, проверку статуса и получение транскрипта.
Опубликованный на Habr тест 2025 года показал неудачный результат SpeechKit Playground на части файлов, включая повторы строк. Это полезный сигнал, но не универсальная оценка всей платформы: автор использовал собственный набор из 16 записей, а ошибки запроса включал в WER. Перед внедрением SpeechKit нужно тестировать на звонках и записях именно вашего домена.
4. Google Cloud Speech-to-Text с Chirp 3
Сравнивать Whisper с абстрактным Google Speech в 2026 году некорректно. Актуальная многоязычная модель Google называется Chirp 3. Она поддерживает русский язык, потоковое и пакетное распознавание, автоматическую пунктуацию, адаптацию под фразы и автоматическое определение языка.
Для длинного аудио используется BatchRecognize. В документации Chirp 3 указан типовой диапазон от одной минуты до одного часа. Русский доступен для транскрибации, но диаризация Chirp 3 на момент проверки перечислена только для ограниченного набора языков, без ru-RU.
Google удобен компаниям, которые уже работают в Google Cloud и готовы хранить аудио в облачной инфраструктуре проекта. Сильные стороны здесь не сводятся к качеству отдельной модели: IAM, региональные endpoints, журналирование, квоты и масштабирование входят в общую платформу.
Заявлять, что Google всегда хуже Whisper на русском, без единого контролируемого теста нельзя. На чистой диктовке разница может быть небольшой, а на телефонной записи с отраслевой лексикой порядок моделей способен измениться.
Техническое сравнение STT-моделей для русского языка
Таблица показывает, почему вопрос о лучшей модели распознавания речи нельзя закрыть одной цифрой WER. Сначала определите сценарий: звонки, интервью, субтитры, поток или архив. Затем соберите тестовый набор хотя бы из 20–50 своих файлов и посчитайте не только ошибки слов, но и стоимость ручной правки.
Боль бэкендера: почему поднять свой Whisper сложнее, чем кажется
Склейка чанков
Разделить аудио через FFmpeg несложно. Сложно разделить его так, чтобы фраза не оборвалась на полуслове. Обычно сегменты делают с перекрытием. После распознавания нужно найти повторяющийся участок текста, удалить дубль и сохранить таймкоды.
На одном чистом монологе эвристика работает. На совещании с короткими репликами, паузами и перебиваниями она начинает ошибаться. Чем больше правил добавляется, тем сильнее проект превращается из вызова модели в отдельную ASR-платформу.
Галлюцинации на тишине
Музыка, длинная пауза, шум зала и тихая речь могут запустить ложную генерацию. Whisper иногда повторяет последнюю фразу или создает типовые подписи, которых не было в аудио.
Production-конвейер использует VAD, минимальную длительность речи, пороги уверенности, контроль компрессии текста и поиск повторяющихся последовательностей. После этого все равно нужен журнал проблемных сегментов для повторной обработки.
Форматы и лимиты
Пользователь загружает не только MP3. На вход приходят WAV, M4A, OGG, FLAC, MP4, AVI, записи телефонии с двумя каналами и файлы с нестандартной частотой дискретизации. Их нужно проверить, извлечь аудиодорожку, привести к ожидаемому формату и не потерять метаданные времени.
Лимит OpenAI в 25 МБ добавляет еще один слой: сжатие, нарезку, очередь запросов и сборку результата. Размер файла при этом не равен длительности. 25 МБ могут содержать короткий WAV или длинный MP3 с низким битрейтом.
GPU и неравномерная нагрузка
Собственный сервер выгоден при предсказуемом постоянном потоке. При редких загрузках видеокарта простаивает. При резком наплыве файлов возникает очередь, пользователи ждут, а команде приходится добавлять воркеры и следить за памятью.
К стоимости GPU прибавляются хранение файлов, мониторинг, повторные задания, обновление CUDA, безопасность, резервирование и поддержка форматов. Бесплатная модель не означает бесплатный сервис.
Практический вывод: использовать модель или готовую систему
Для исследовательского проекта разумно поднять Whisper или VibeVoice локально. Вы получите контроль над кодом, данными и параметрами. Для продукта важнее другой вопрос: кто отвечает за длинные файлы, сбои, диаризацию, форматы и качество текста на стыках.
Заключение
Whisper, VibeVoice, Yandex и Google решают разные части одной задачи. Whisper дает сильное качество базовой транскрибации, VibeVoice сохраняет часовой контекст, Yandex предлагает развитый набор режимов для русского языка, Google встраивает STT в масштабируемую облачную платформу.
На практике качество определяет весь конвейер: подготовка аудио, VAD, склейка сегментов, диаризация, пунктуация, контроль повторов и обработка ошибок. Поэтому бизнесу часто выгоднее тестировать не голую модель, а готовый результат на своих файлах.






Комментарии